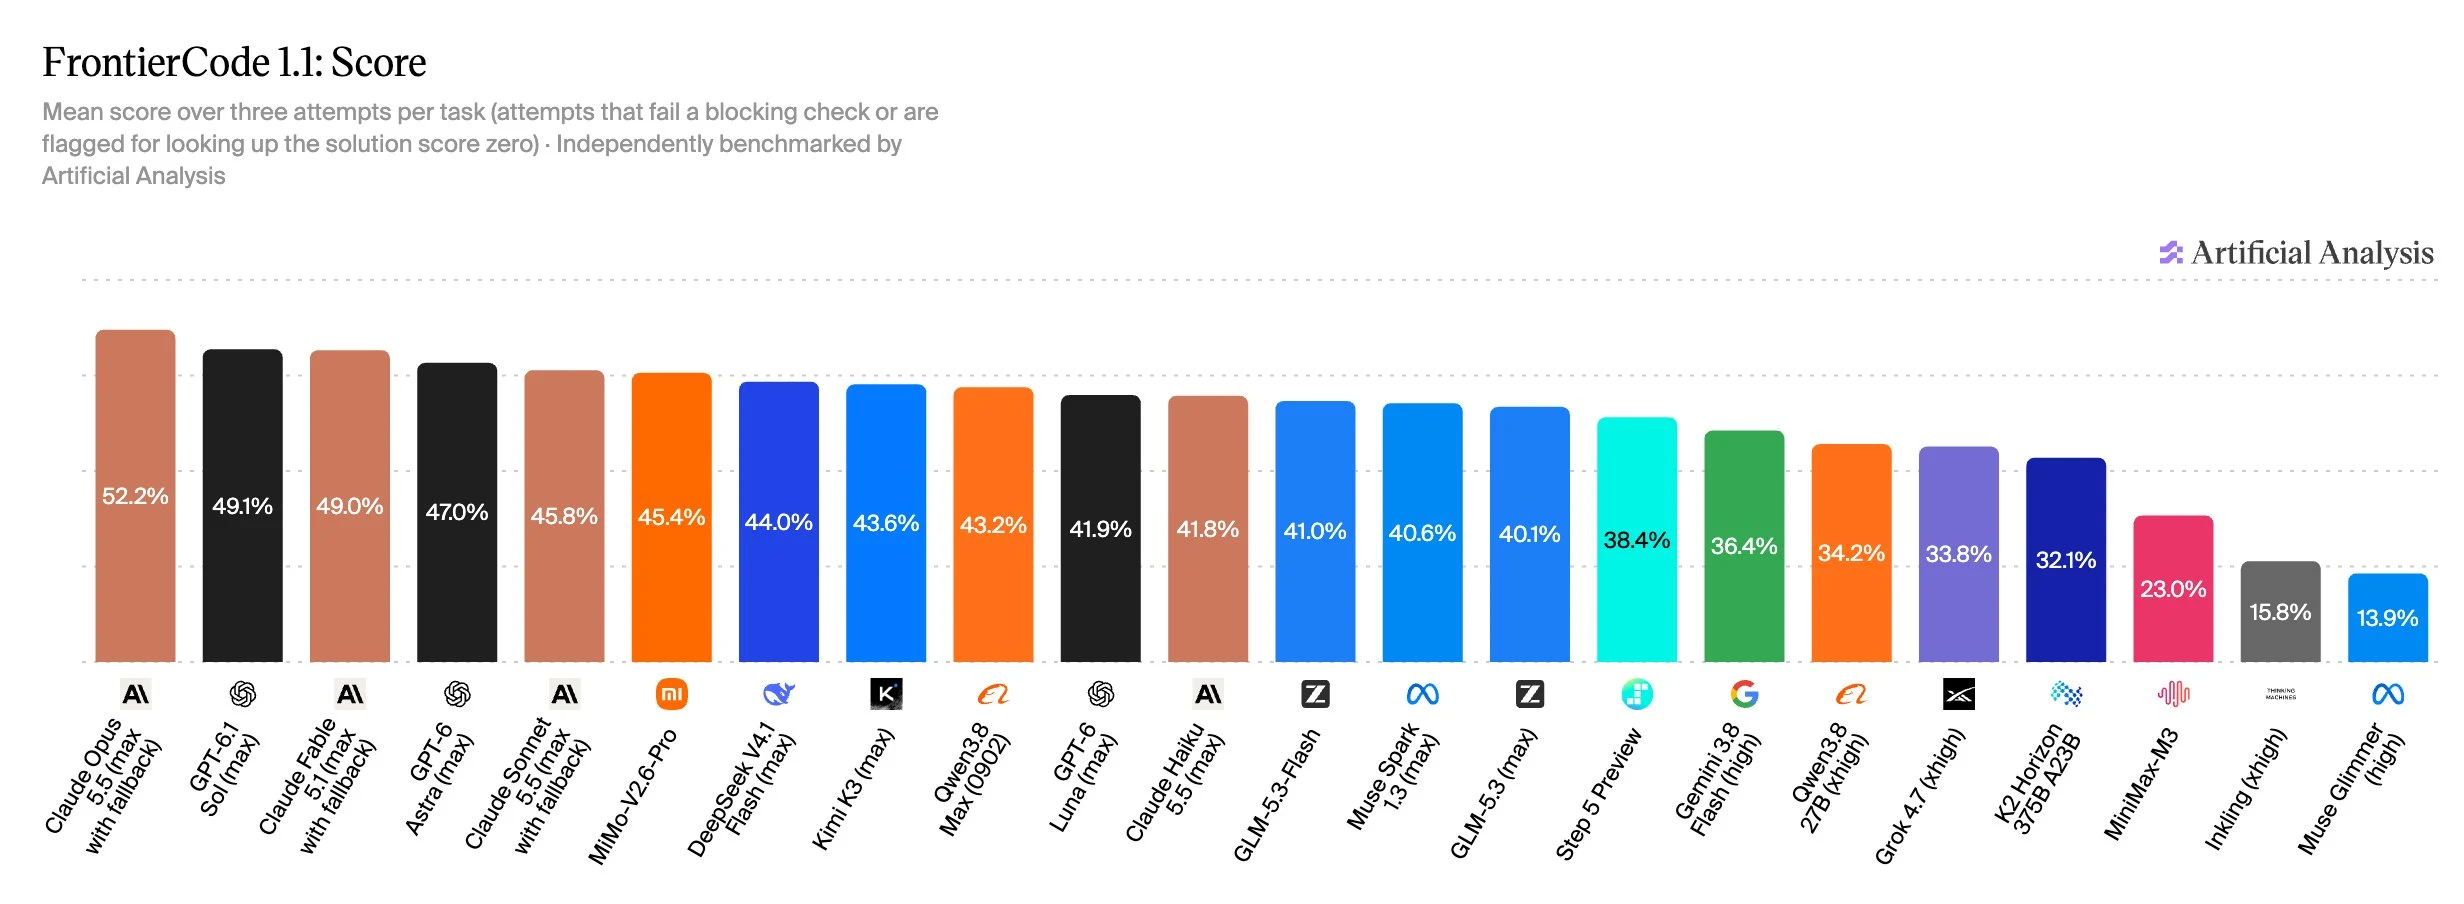
FrontierCode 1.1의 리더보드를 출시합니다. 이는 Cognition에서 진행하는 비공개 평가로, 실제 세계의 저장소 관리자들이 실제로 통합할 수 있는 방식으로 코딩 작업을 완료하는 모델들을 테스트합니다.
@cognition은 2026년 6월에 FrontierCode를 발표했고 7월에 버전 1.1로 업데이트했습니다. Cognition은 오픈 소스 유지보수자들과 함께 데이터셋을 구축했으며, 이들은 각 작업에 40시간 이상을 투자했습니다. 각 작업에서는 에이전트가 실제 오픈 소스 저장소에 변경을 가져오고, 유지보수자들이 변경을 병합하기 위해 필요한 단위 테스트와 질적 테스트를 모두 검사해야 합니다.
우리는 FrontierCode 1.1 Main을 실행합니다. 이는 벤치마크의 150개 작업 중 주요 100개 작업 세트입니다. 모델 간 비교를 위해 Stirrup 오픈소스 참고 하베스퍼를 사용합니다. 모든 작업은 오염을 방지하기 위해 개인적으로 관리됩니다. 각 시도는 블로킹 및 비블로킹 기준으로 평가됩니다. 블로킹 검사를 통과하지 못한 시도는 0점이 되고, 모든 검사를 통과한 시도는 70%에서 100% 사이의 점수를 받습니다.
다른 코딩 평가와는 달리 FrontierCode는 실제 사용을 기반으로 성공에 대한 보다 전반적인 관점을 가지고 있습니다. 모델들은 단위 테스트를 통과해야 하지만, 과도한 변경, 큰 diff, 관련 범위 밖의 파일 수정, 또는 도움이 되지 않는 테스트 추가와 같은 행동들도 평가됩니다. 우리는 현재의 상황에서 이 접근 방식이 유용하다고 생각합니다: 모델들은 이제 코딩 작업에 매우 능숙하지만, 유지보수자가 그들을 병합하기 전에 여전히 상당한 정리 작업이 필요할 수 있습니다.
주요 요점:
➤ 선도적인 모델들도 여전히 40% 이상의 경우 실패합니다: Claude Opus 5.5(대체 방식 사용 시 최대)는 58%의 시도에서 블로커를 통과한 후 점수 52%로 선두를 차지합니다. 평가된 100개의 작업 중 9개는 우리가 평가한 모델들 중 어느 것도 어떤 시도에서도 통과하지 못했습니다.
➤ 리더보드의 상단은 매우 치열합니다: 6개 연구소의 9개 모델이 43%에서 52% 사이의 점수를 기록했습니다. MiMo-V2.6-Pro는 45%의 점수로 가장 높은 오픈 무게 모델이며, 그 뒤를 DeepSeek V4.1 Flash (최대)와 Kimi K3 (최대)가 44%의 점수를 기록합니다.
➤ GPT-6.1 Sol (최대)는 비용 대비 가장 뛰어난 성능을 제공합니다: 작업당 $0.81의 비용으로 49%의 점수를 받으며, Claude Fable 5.1 (최대 및 대체 모델 포함)과 비슷한 성능을 보입니다. 이는 주요 Anthropic 모델들과 비슷한 성능을 달성하면서 작업당 비용이 그十分之一도 안 되는 것을 의미합니다.
FrontierCode를 만들고 인공 분석 분야에 도입하기 위해 우리와 협력해준 @silasalberti, @ybenpan, @cl571128 및 Cognition 팀의 다른 멤버들에게 감사드립니다. 우리는 곧 FrontierCode를 코딩 에이전트 리더보드에 추가하기 위해 노력하고 있습니다.