
Muse Wonder와 Muse Wonder Full: 이전 Meta 모델 대비 지능의 실질적 도약
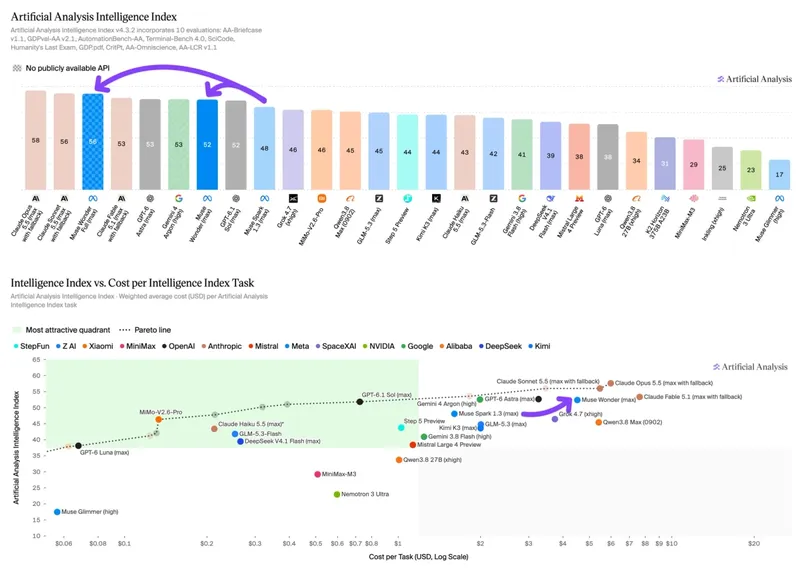
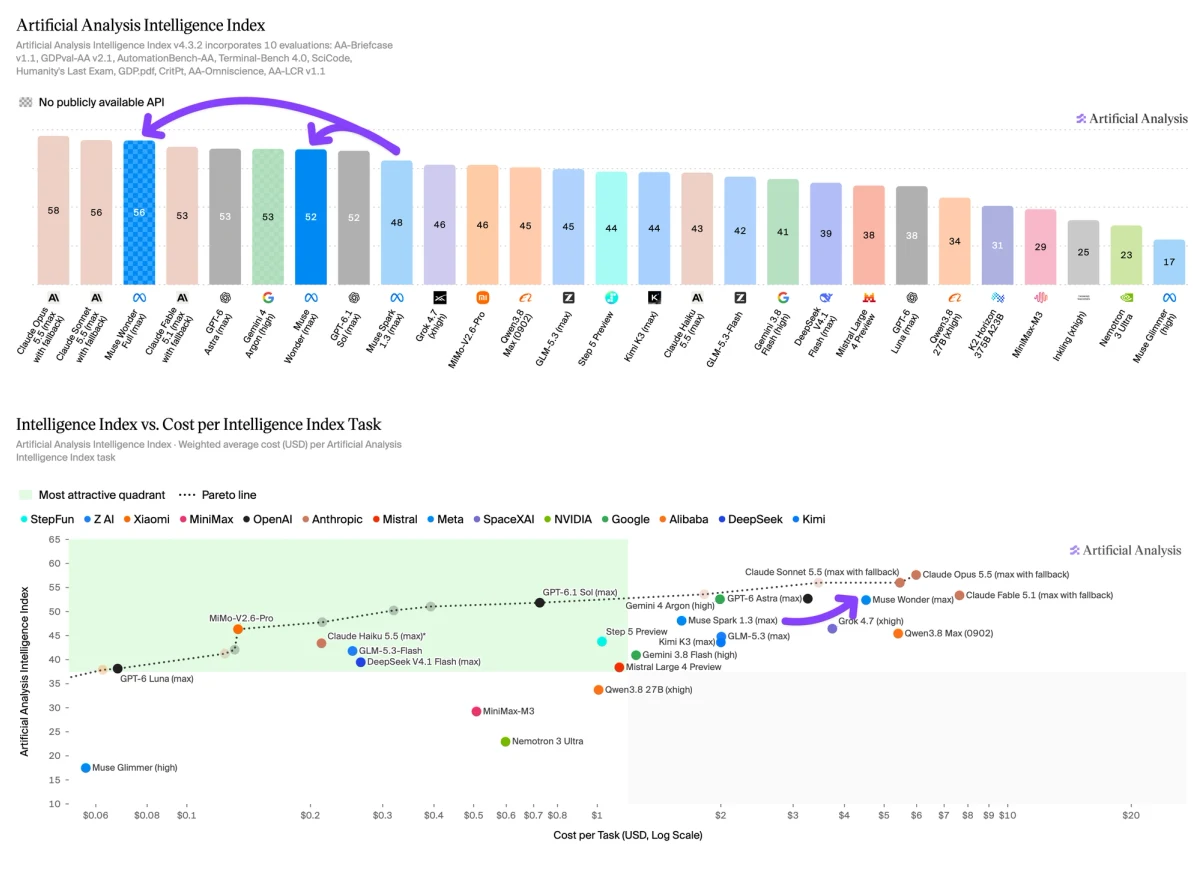
모델 페이지 보기Meta가 Muse Wonder와 Muse Wonder Full을 출시하며, 최대 추론 노력(max reasoning effort)에서 Artificial Analysis Intelligence Index v4.3 점수 52점과 56점을 기록했습니다. 이는 각각 48점인 Muse Spark 1.3 (max) 대비 실질적인 향상이며, 출시 간격은 단 6주였습니다
Muse Wonder는 Meta의 자체(first-party) API 사용자에게 제공되며, Muse Wonder Full은 현재 Muse Code 사용자에게만 제공됩니다. Meta는 두 모델 모두 개인 및 전문 에이전트 용도로 설계되었다고 밝혔습니다
주요 요점:
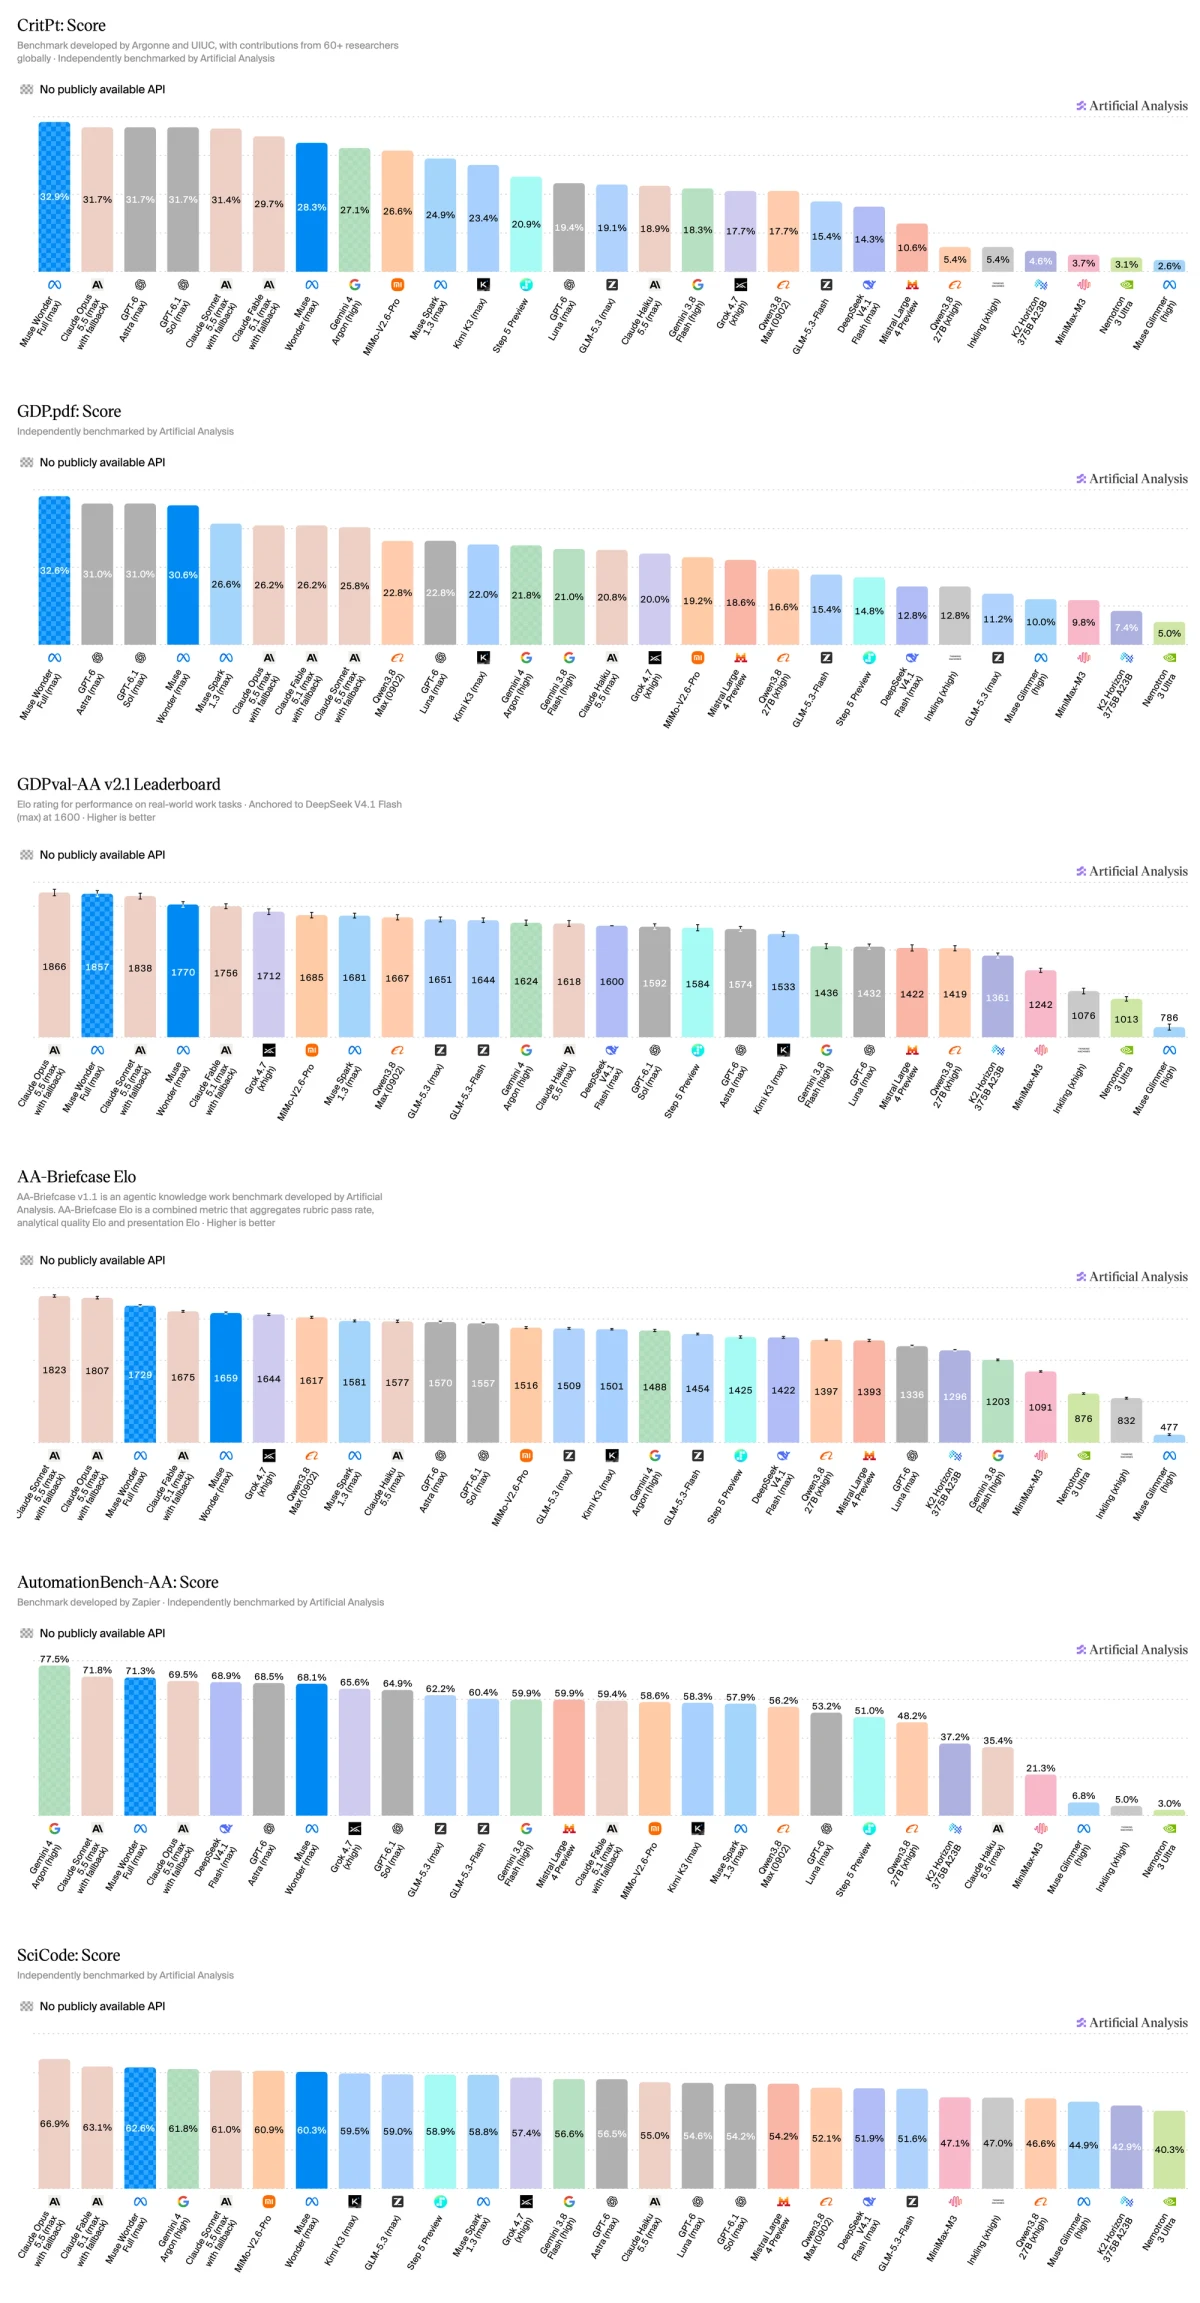
➤ 두 모델 모두 전체 Intelligence Index 점수에서 실질적인 도약을 보여줍니다. Muse Wonder Full (max)은 10개 Intelligence Index 평가 전체에서 Muse Spark 1.3 (max)을 개선하여 8점을 얻어 56점에 도달했습니다. 가장 큰 향상은 에이전트 평가에서 나타났습니다: Terminal-Bench 4.0 (+24점, 33%에서 57%), GDPval-AA v2.1 (+176 Elo, 1681에서 1857), AA-Briefcase (+148 Elo, 1581에서 1729). Muse Wonder (max)는 4 Intelligence Index 점수를 얻어 52점에 도달했으며, Terminal-Bench 4.0 (33%에서 52%)과 AutomationBench-AA (58%에서 68%)에서 Muse Spark 1.3 (max) 대비 눈에 띄는 향상을 보였습니다
➤ Muse Wonder Full (max)은 10개 Intelligence Index 평가 중 6개에서 상위 3위 안에 들며, 특히 에이전트 기반 지식 작업과 과학적 추론에서 강력한 성능을 보입니다. 에이전트 기반 지식 작업에서는 GDP.pdf (33%)에서 근소한 차이로 1위, GDPval-AA v2.1 (1857 Elo)에서 2위, AA-Briefcase (1729 Elo)와 AutomationBench-AA (71%)에서 3위를 차지했습니다. 과학적 추론에서는 CritPt 리더보드에서 33%로 1위를 차지했으며, SciCode에서 63%로 3위를 기록했습니다. 이는 이 두 분야에서 특히 뛰어난 능력을 보였던 Muse Spark 1.3 (max)의 상대적 강점을 바탕으로 한 것입니다
➤ 두 모델 모두 Muse Spark 1.3 (max)보다 적은 출력 토큰을 사용합니다. Muse Wonder (max)와 Muse Wonder Full (max)은 각각 Intelligence Index 작업당 약 54k 출력 토큰을 사용하며, 이는 Muse Spark 1.3 (max, 60k) 대비 약 10% 감소한 수치입니다. 이 사용량은 비슷한 지능 수준의 모델인 Gemini 4 Argon (high, 62k)과 Claude Fable 5.1 (max w/ fallback, 78k)보다는 낮지만, GPT-6.1 Sol (max, 38k)과 GPT-6 Astra (max, 27k)보다는 높습니다. Muse Wonder Full (max)은 Intelligence Index 작업당 Muse Wonder (max)보다 입력 토큰을 16% 적게 사용하며(6.44M 대 7.69M), 이는 더 지능적이면서 토큰 효율성도 더 높다는 의미입니다
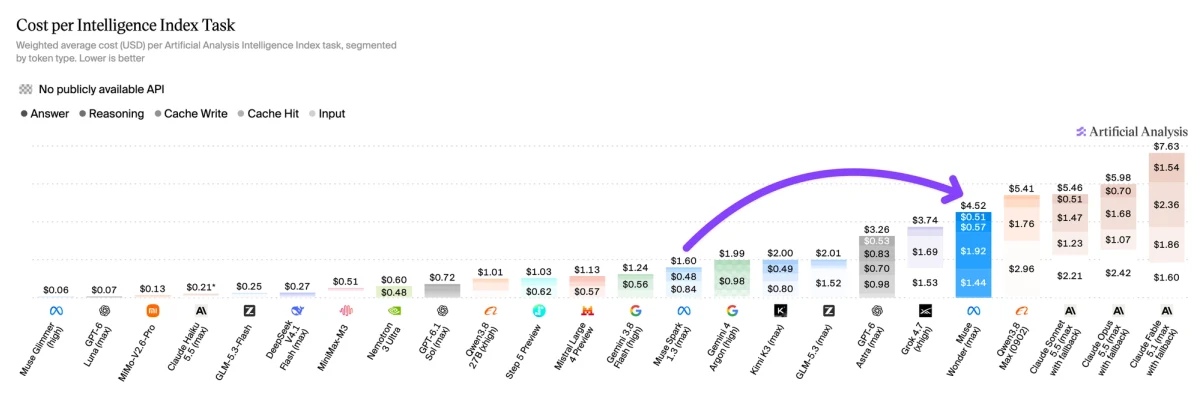
➤ Muse Wonder (max)의 작업당 비용(Cost per Task)은 비슷한 지능 수준의 대부분의 모델보다 높습니다. 효율적인 출력 토큰 사용에도 불구하고, 프리미엄 API 가격(입력 토큰 백만 개당 $4, 출력 토큰 백만 개당 $20)과 높은 입력 토큰 사용량(작업당 7.69M)으로 인해 Muse Wonder (max)의 비용은 Intelligence Index 작업당 $4.52에 달합니다. 이는 Claude Fable 5.1 (max w/ fallback, $7.63), Claude Opus 5.5 (max w/ fallback, $5.98), Claude Sonnet 5.5 (max w/ fallback, $5.46)보다는 낮지만, GPT-6 Astra (max, $3.26), Gemini 4 Argon (high, $1.99), GPT-6.1 Sol (max, $0.72), 그리고 이전 모델인 Muse Spark 1.3 (max, $1.60)보다는 높습니다. Muse Wonder Full은 토큰당 가격이 책정되지 않아 작업당 비용 수치를 확인할 수 없습니다
➤ 두 모델 모두 코딩 에이전트 성능에서 크게 향상되었습니다. Muse Wonder Full은 Muse Code에서 최대 노력(max effort)으로 Artificial Analysis Coding Agents Index에서 68점을 기록했으며, 이는 Sonnet 5.5 (max, 68) 및 Opus 5.5 (max, 66)와 함께 Claude Code의 성적과 어깨를 나란히 합니다. Muse Wonder (max)는 63점을 기록했습니다. 이는 54점을 기록한 Muse Code with Muse Spark 1.3 (max) 대비 실질적인 향상입니다
두 새 모델에 대한 기타 세부 사항:
➤ 컨텍스트 윈도우: 각각 1M 토큰, Muse Spark 1.3과 동일
➤ 가격: Muse Wonder의 경우 1M 토큰당 입력 $4 / 캐시된 입력 $0.20 / 출력 $20. Muse Wonder Full은 토큰당 가격이 책정되지 않음
➤ 입력 모달리티: 텍스트, 이미지, 비디오, 오디오
➤ 출력 모달리티: 텍스트
➤ 가용성: Muse Wonder는 출시 시점에 Meta의 자체 API와 Muse Code에서 이용 가능하며, Muse Wonder Full은 Muse Code 사용자에게만 제공됩니다
Muse Wonder Full (max)은 10개 Artificial Analysis Intelligence Index v4.3 평가 중 6개에서 상위 3위 안에 들었습니다:
➤ CritPt (33%)와 GDP.pdf (33%)에서 1위
➤ GDPval-AA v2.1 (1857 Elo)에서 2위
➤ AA-Briefcase (1729 Elo), AutomationBench-AA (71%), SciCode (63%)에서 3위
CritPt과 GDP.pdf에서의 리드는 적으며, 가장 근접한 경쟁 모델들이 31-32%를 기록했습니다. GDPval-AA v2.1에서는 그 결과가 Claude Opus 5.5(max w/ fallback, 1866)와 Claude Sonnet 5.5(max w/ fallback, 1838)의 신뢰 구간 내에 있습니다.
Muse Spark 1.3 (max) 대비 가장 큰 개선은 Terminal-Bench 4.0으로, 33%에서 57%로 상승하여 Gemini 4 Argon (high)과 동급이 되었습니다.
Muse Wonder (max)는 Artificial Analysis Intelligence Index 과제당 $4.52의 비용이 들며, 이는 Muse Spark 1.3 (max, $1.60)의 2.8배로, 더 높은 토큰당 가격과 더 많은 입력 토큰 사용에 기인합니다.
➤ 토큰 가격: 1M 입력 토큰당 $4, 캐시된 토큰 $0.20, 출력 토큰 $20으로, Muse Spark 1.3의 $1.25 / $0.15 / $4.25에서 인상되었습니다. 이는 Claude Opus 5.5와 동일하며, Claude Sonnet 5.5, Gemini 4 Argon, GPT-6.1 Sol ($2/$10) 각각의 2배이고, GPT-6 Astra와 Claude Fable 5.1 ($10/$50)보다는 60% 낮습니다.
➤ 입력: 과제당 7.69M 입력 토큰으로, Muse Spark 1.3 (max, 6.03M)보다 28% 많고, Gemini 4 Argon (high), GPT-6.1 Sol (max), GPT-6 Astra (max)의 2-7배입니다. 입력 비용은 과제당 비용의 $3.43 (76%)를 차지하며, $1.92의 캐시 쓰기, $1.44의 캐시 히트, $0.07의 비캐시 입력으로 구성됩니다.
➤ 출력: 과제당 약 54k 출력 토큰 ($1.08)으로, Muse Spark 1.3 (max, 60k)보다 10% 적습니다.
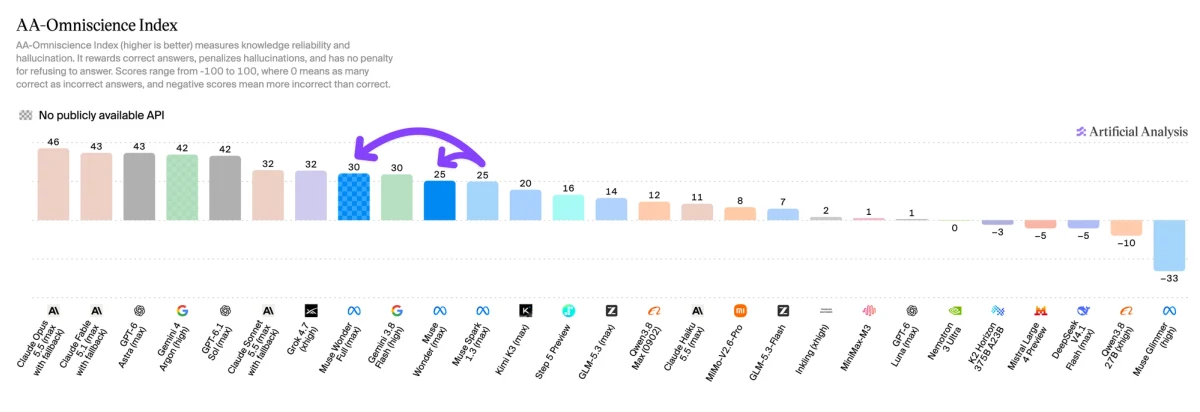
지식은 두 모델 모두에게 여전히 상대적인 약점이지만, 매우 낮은 환각률로 인해 완화됩니다. AA-Omniscience에서 Muse Wonder Full (max)은 30점, Muse Wonder (max)은 25점을 기록하여 Muse Spark 1.3 (max)과 동률이며, Claude Opus 5.5 (46), GPT-6 Astra (43), Gemini 4 Argon (42), Claude Sonnet 5.5 (32)보다 낮습니다.
Muse Wonder Full (max)의 5점 상승은 환각률을 낮춘 데서 비롯되었으며(33%에서 23%로), 이를 통해 테스트된 모델 중 가장 환각이 적은 모델 중 하나가 되었습니다. Intelligence Index에서 45점 이상을 기록한 모델 중 환각률이 두 번째로 낮으며, Gemini 4 Argon (high, 15%)에 이어 두 번째입니다. Muse Wonder (max)은 27%로 세 번째입니다.
Muse Wonder Full (max) 및 Muse Wonder (max)의 전체 Artificial Analysis Intelligence Index 결과:
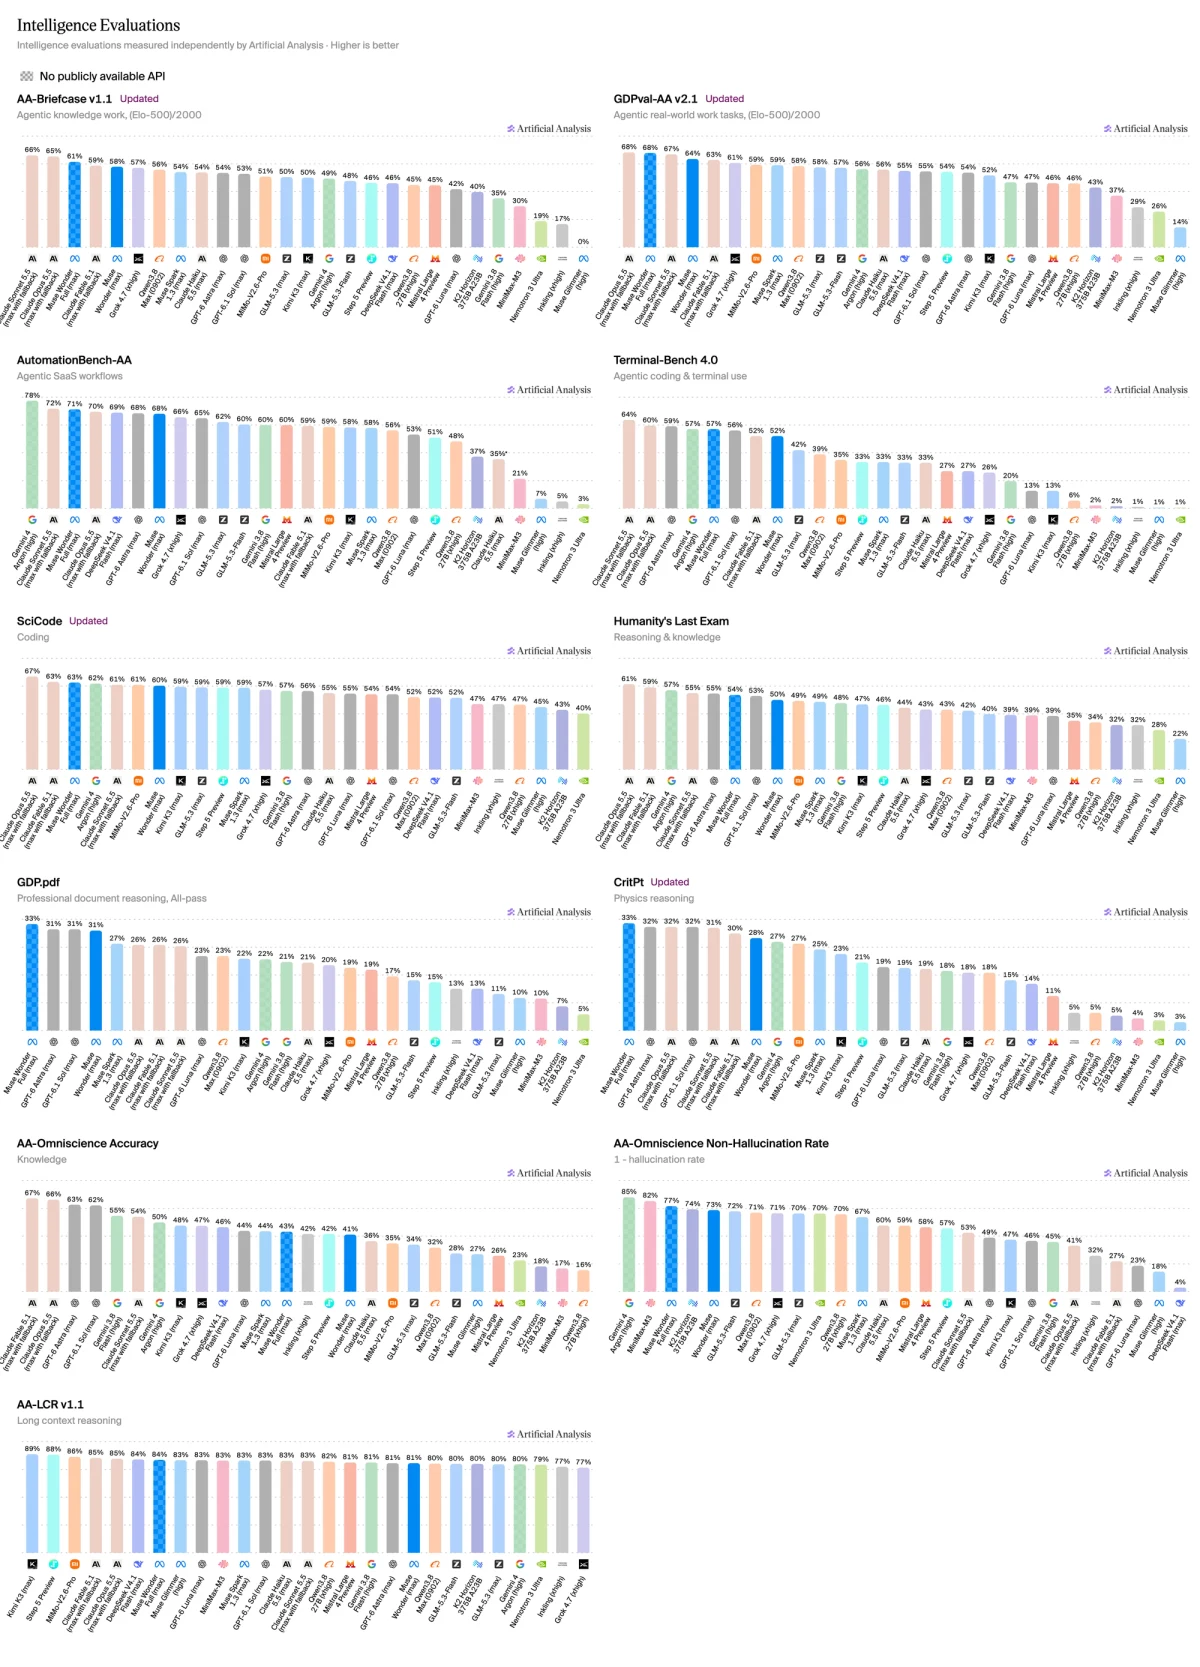
Muse Wonder Full (max) 및 Muse Wonder (max)를 다른 선도적 모델과 다음에서 비교해 보세요: https://artificialanalysis.ai/models/muse-wonder-full 및 https://artificialanalysis.ai/models/muse-wonder