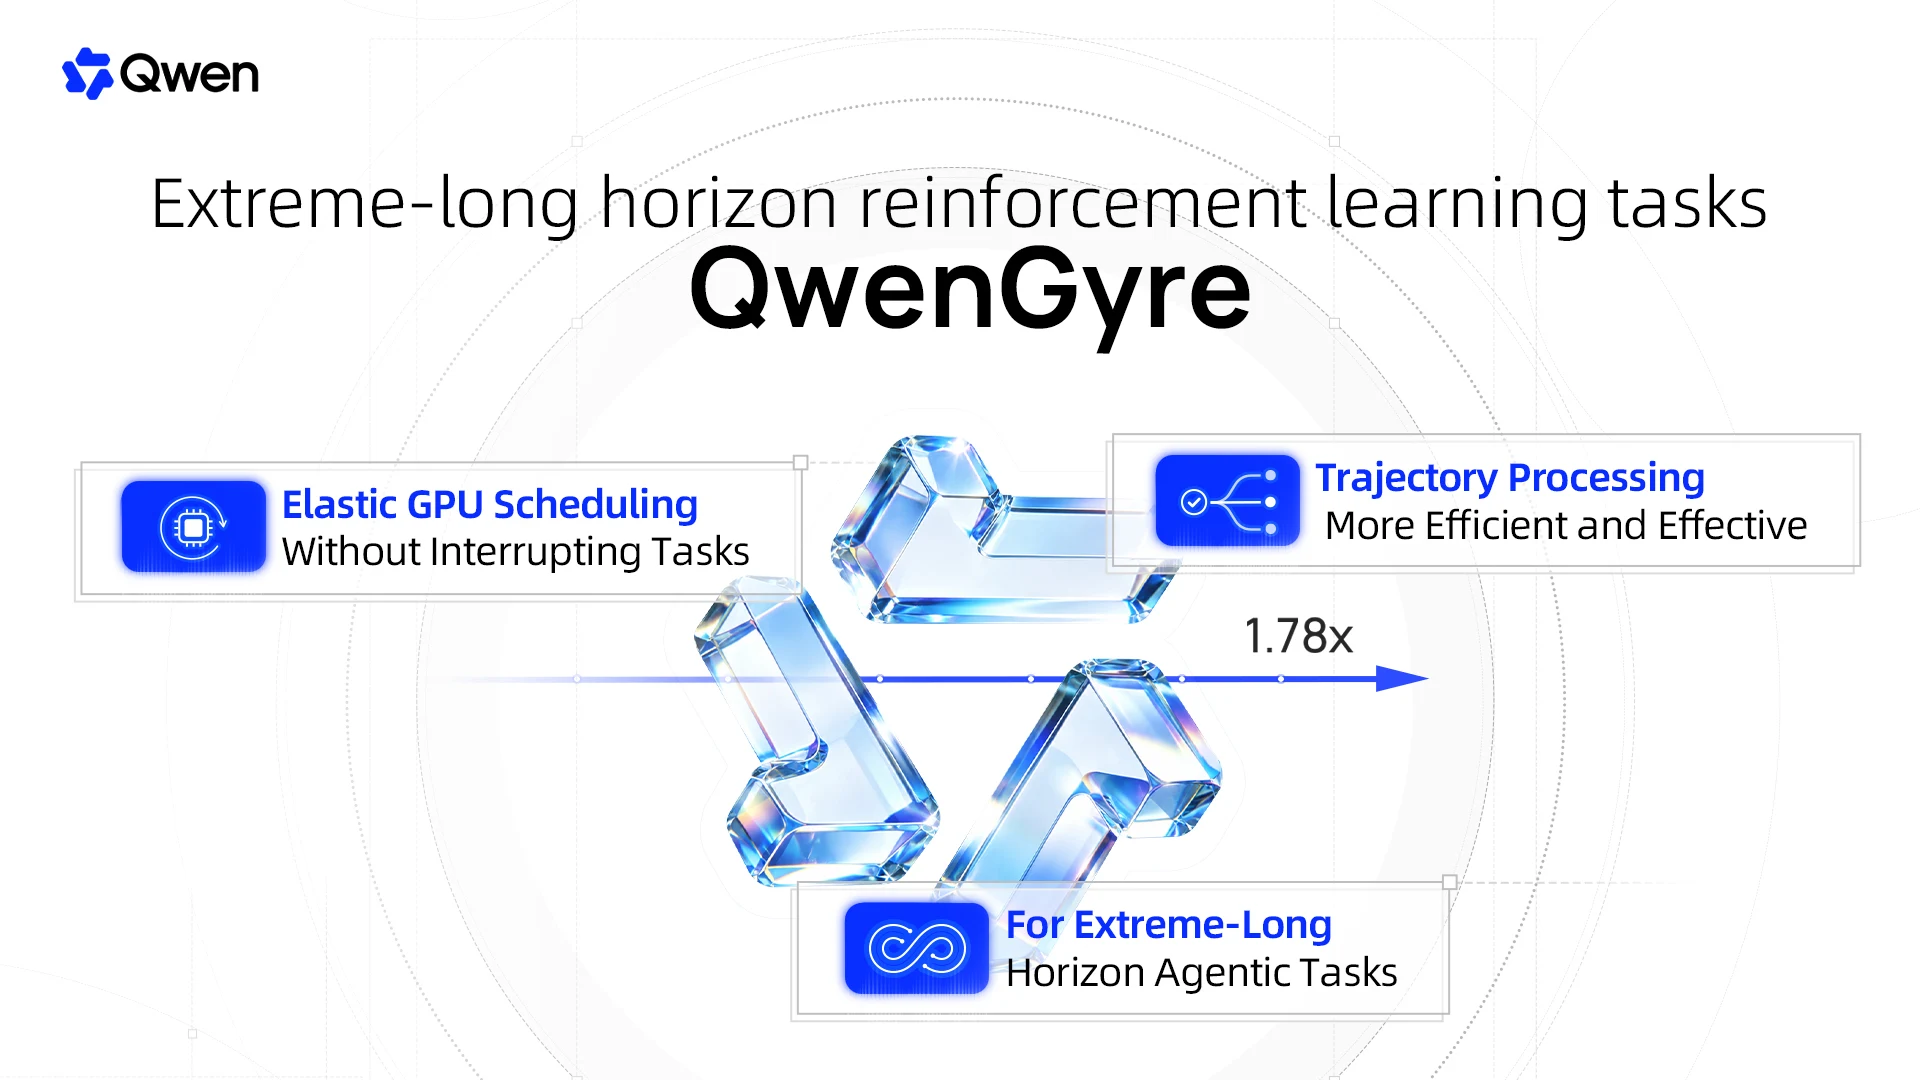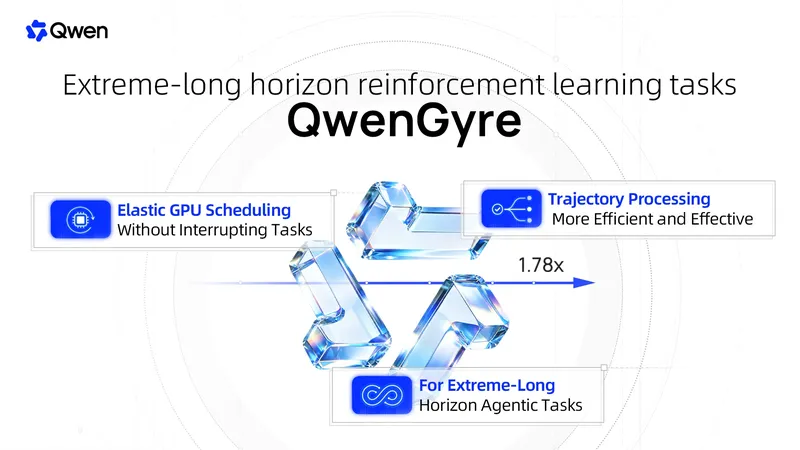
隆重推出 QwenGyre,为极端长程(XLong)智能体训练带来弹性强化学习。✨
它以两项核心设计亮相:🥳
- 弹性调度器(Elastic Scheduler):随需求变化在 rollout 与训练之间重新分配 GPU——运行中的执行永不中断。相比 Colocate 最高提速 1.85×,相比 Async 提速 1.78×。
- 轨迹处理器(Trajectory Processor):将分支执行(压缩、子智能体、重试)转化为前缀共享的轨迹树,训练样本有界且去重。超时后的部分进展仍会被评分。
扩展至 Qwen3.8-2.4T-A95B,每次 rollout 约 700K token,QwenGyre 在 48 步内将 NL2RepoBench 从 52.5% 提升至 58.5%,端到端训练时间相比 Async 缩短约 44%。
🔗 论文链接:
https://arxiv.org/abs/2609.33848