
随着AI工厂从兆瓦级增长到吉瓦级,建造它们所需的不仅仅是先进计算。开放标准正在帮助行业更快、更高效、更可靠地扩展AI基础设施。
在圣何塞McEnery会展中心举行的开放计算项目(OCP)全球峰会上,NVIDIA宣布了新的合作伙伴关系和贡献,旨在为下一代AI基础设施打造一个共同的基础。
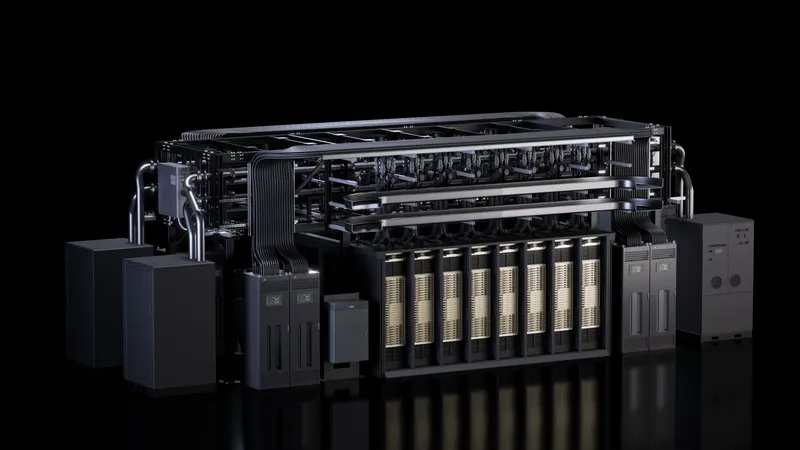
NVIDIA通过开放的 NVIDIA MGX 架构向OCP贡献了关键的 NVIDIA Vera Rubin 机架和计算托盘设计,为系统制造商提供了开发下一代AI工厂基础设施的共同基础。
这些努力共同涵盖了AI工厂本身、为其供电的公用电网以及现代加速计算核心的机架级架构。
NVIDIA与合作伙伴宣布开放架构进展
在OCP活动上,NVIDIA与合作伙伴发布了多项公告:
- NVIDIA与超大规模云服务商发布了下一代AI工厂的开放标准,包括AI工厂设计标准和电网韧性。
- NVIDIA为NVIDIA DSX AI Factory推出了新的开源软件组件。
- Meta和NVIDIA凭借NVIDIA Spectrum-X Ethernet SuperNIC和Spectrum-6创新推进了开放AI网络技术。
- Visionbay推出了一款面向Vera Rubin时代的800V DC AI工厂设计。
- NVIDIA与思科宣布了Ultra-Dense Small Form Factor Pluggable(USFP)标准,这是业界首个面向400Gb/s网络架构的模块。
- NVIDIA与谷歌宣布将在未来的NVIDIA ConnectX-10 SuperNIC和BlueField DPU上支持Falcon Transport。
在座无虚席的观众面前,NVIDIA超大规模与高性能计算副总裁Ian Buck讨论了开放基础设施如何成为全球扩展AI工厂的关键要素。
OCP上的 这一新闻 聚焦于NVIDIA的极致协同设计与开放标准相结合,如何加速部署、提升能效并推动每瓦token性能。
借助OCP上的MGX机架贡献,Vera Rubin AI工厂取得进展
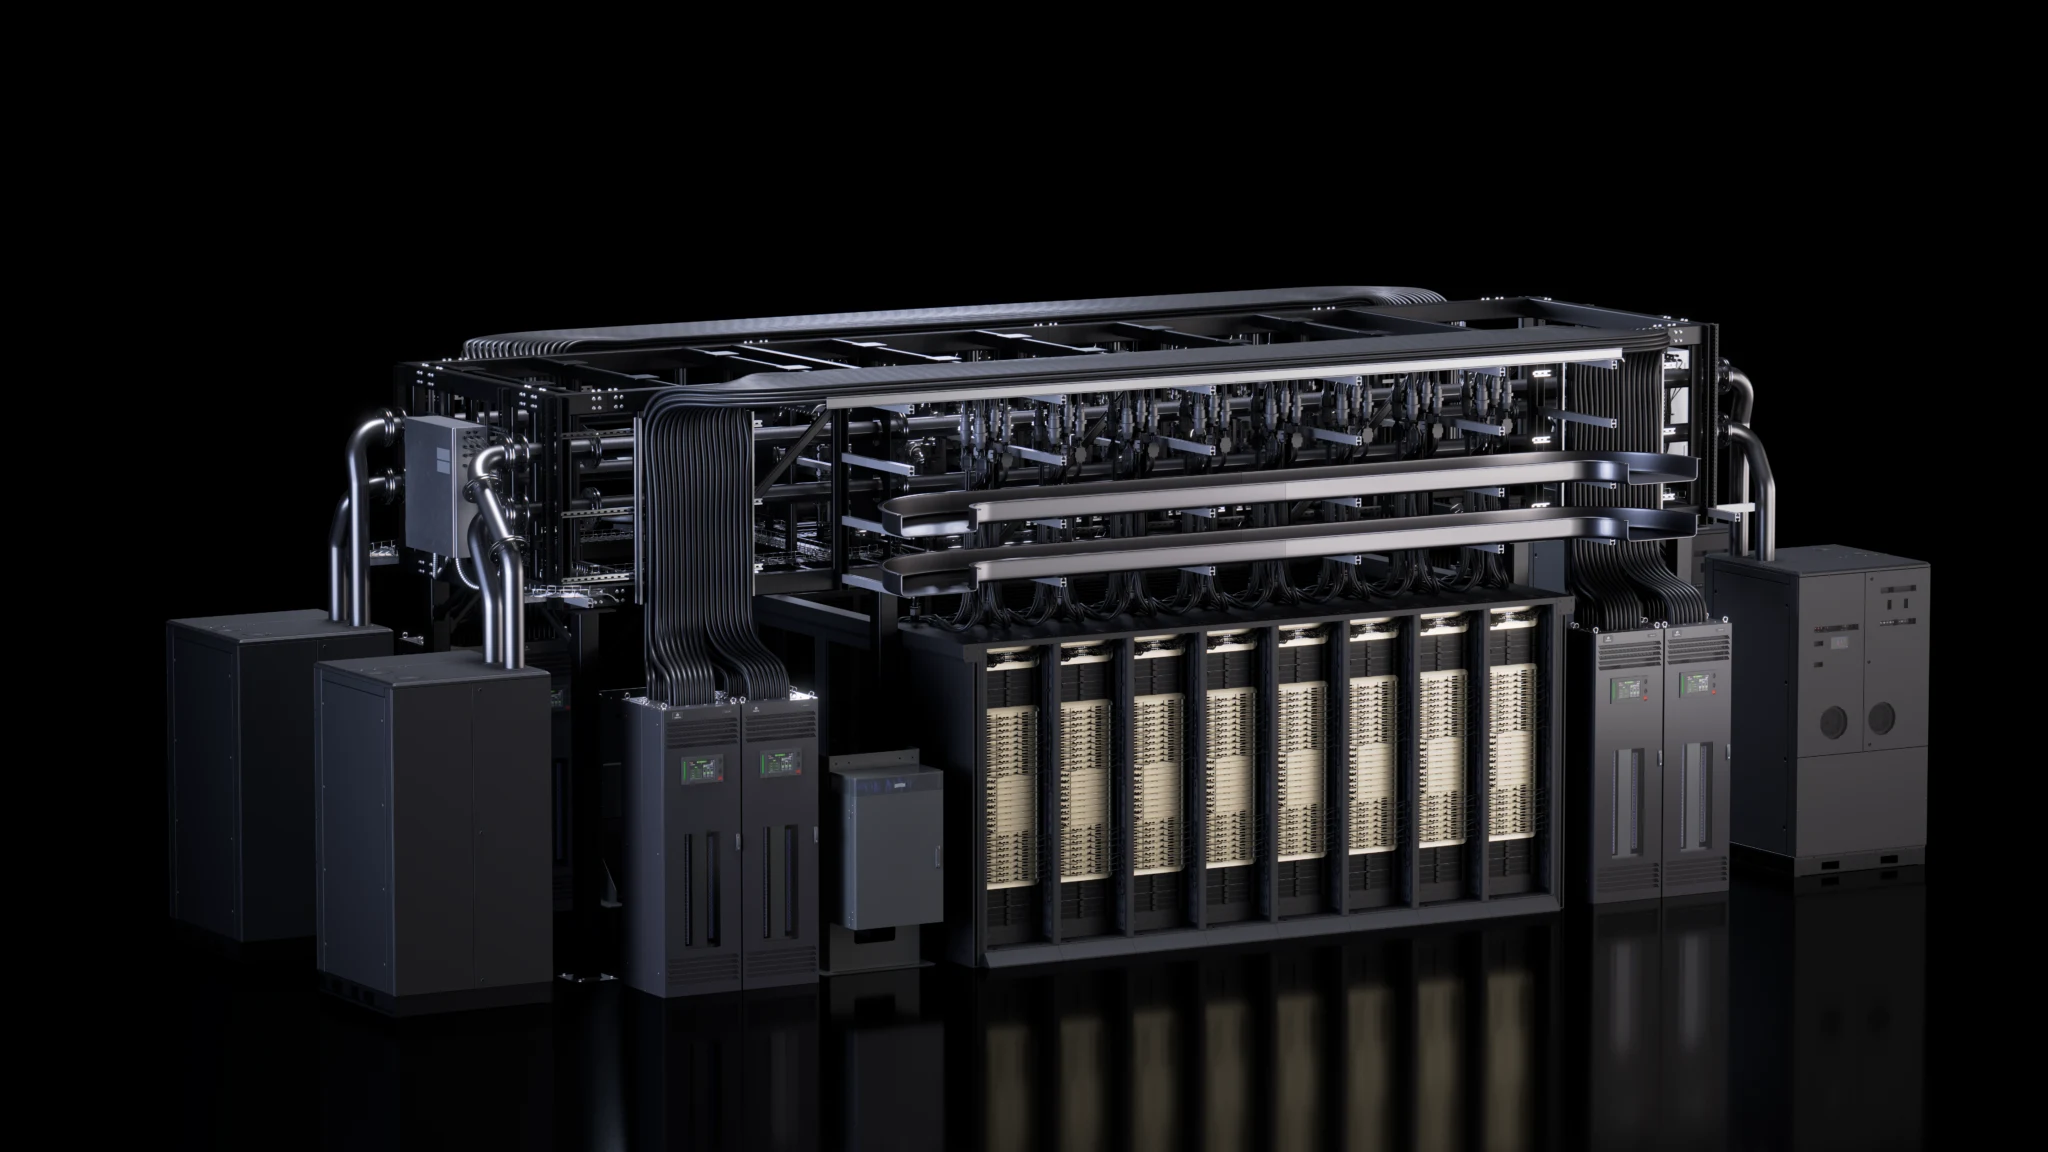
NVIDIA与行业领导者一道,通过OCP的Open DC计划为第三代MGX AI数据中心参考设计做出贡献。
结合MQD和MQDB等开放液冷技术,这一努力有助于将经过验证的AI工厂设计转变为他者可以采用、制造和扩展的行业标准。
对于NVIDIA Vera Rubin AI工厂,更新后的MGX 1.2规范通过机架级盲插液冷、可互操作的机架级互连基础设施以及为更高功率AI系统设计的液冷5,000A母线,扩展了面向AI工厂的开放架构。它还增加了对19英寸设备的原生支持和更高密度的机架设计。
MGX 1.2进一步通过可配置的I/O托架、无风扇液冷计算托盘、标准化的电源和冷却接口以及帮助生态系统合作伙伴构建可互操作加速计算平台的共同基础设施来扩展模块化。它缩短了组装、测试和服务时间,以简化制造和现场服务,从而实现更快、更高效的基础设施建设。该架构支持高达250kW的机架部署,同时简化了可维护性、部署和基础设施复用。
Vera CPU机架设计规范将NVIDIA MGX开放架构扩展到加速计算之外,为日益增长的智能体AI时代提供了一个专门构建的平台。虽然Vera Rubin NVL72是大规模训练和推理的基础,但 NVIDIA Vera CPU 机架旨在支持工具调用、编排和沙箱执行,帮助AI智能体实时与应用、数据和服务交互。
Vera CPU机架基于第三代NVIDIA MGX机架架构构建,共享将计算、网络、电源和冷却统一到一个通用模块化平台中的相同机架级设计原则。这种方法使合作伙伴能够部署专用基础设施,同时受益于共享的生态系统、简化的集成以及下一代AI工厂的一致基础。
NVIDIA推出用于DSX AI工厂的新开源软件组件
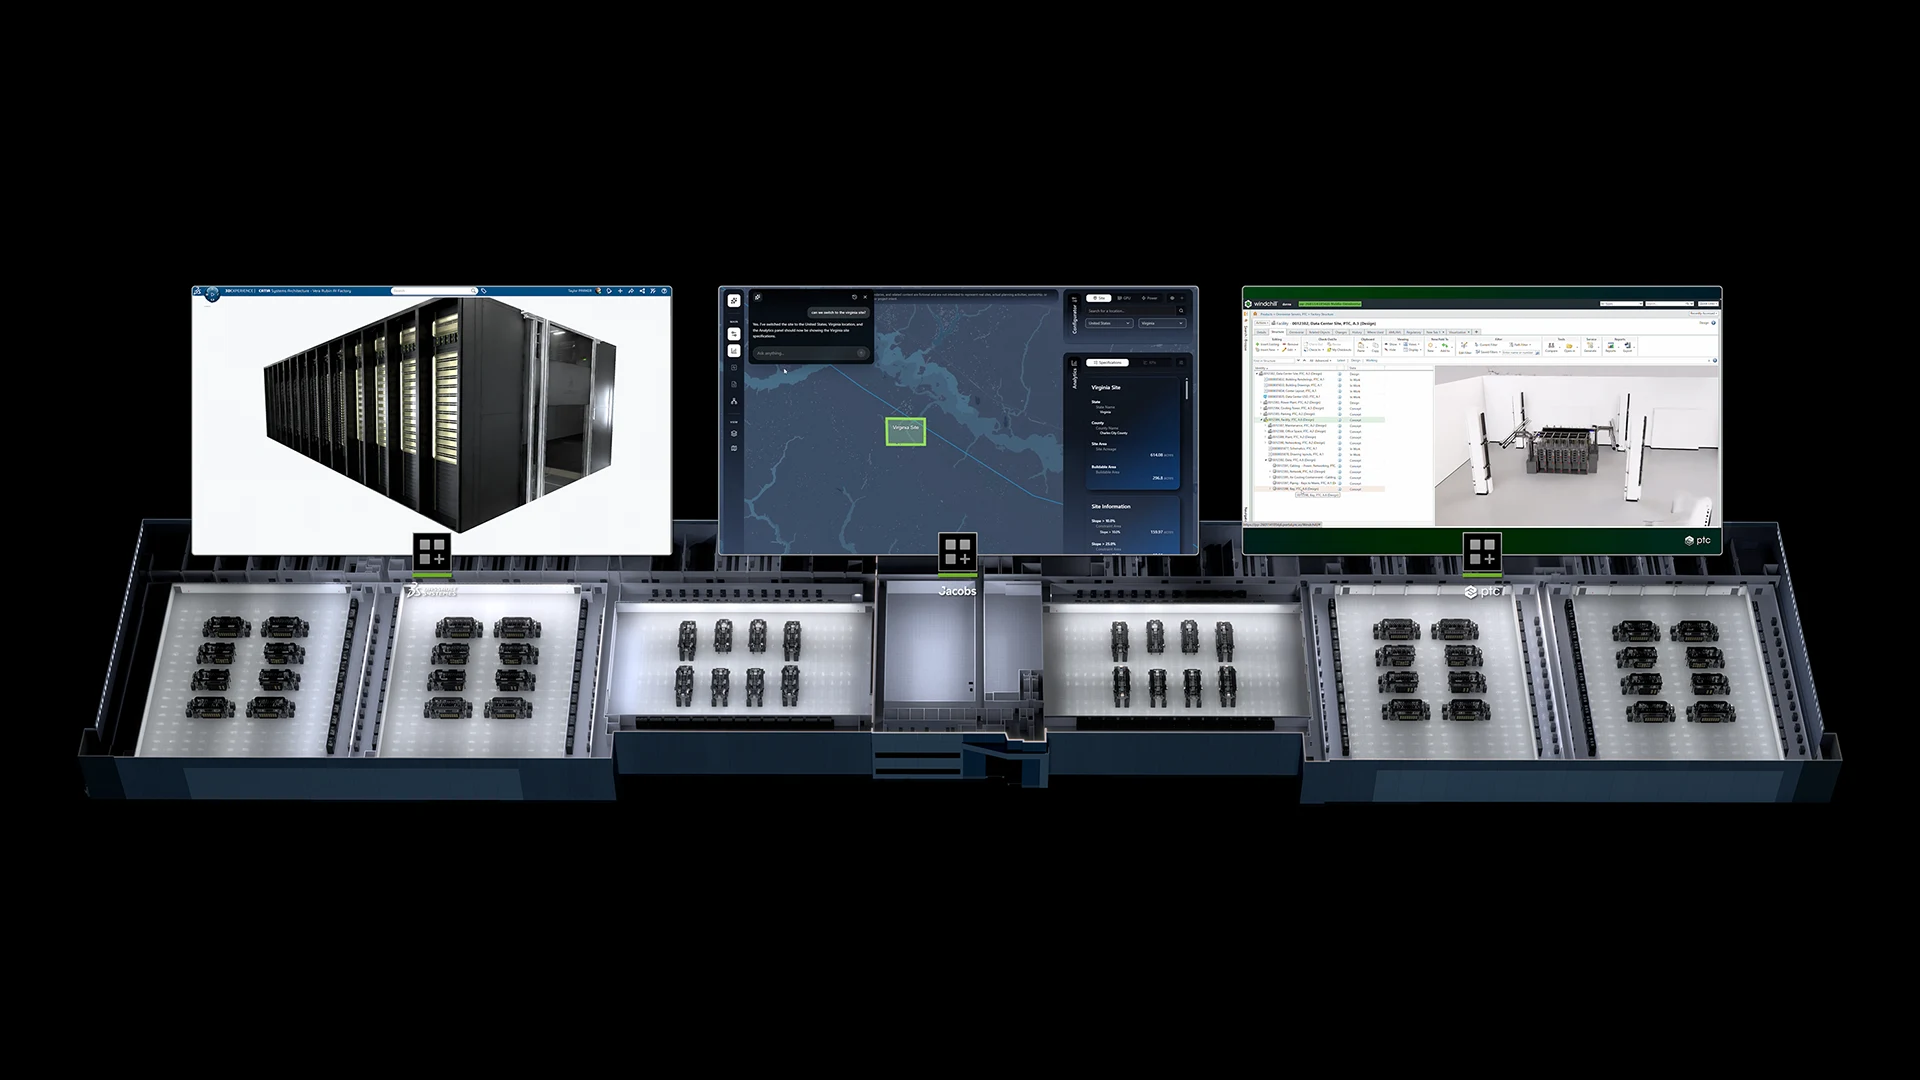
NVIDIA DSX AI 工厂平台 采用极致协同设计,将计算、网络、电力、散热、设施和软件统一起来,帮助 AI 工厂作为一个单一优化系统运行,在现有基础设施约束下最大化 AI 产出。这一统一系统的核心是 DSX OS,这是一个开放的操作层,可将 DSX 架构转化为可协调、可重复的大规模运营。
在 OCP 上,NVIDIA 通过开源组件扩展了 DSX OS,用于配置网络、验证集群、管理机架和裸机配置:
- NVIDIA Config Manager:大规模自动化交换机配置,使客户能够以最少甚至零人工干预来部署、验证和维护一致的 AI 工厂网络架构/
- NVIDIA Cluster Readiness Engine:通过真实工作负载仿真对 GPU 集群进行压力测试,帮助消除代价高昂的作业崩溃,在训练开始前保证硬件健康
- NVIDIA Rack Management Service:提供机架硬件抽象和运营解决方案,将机架视为一等单元,以改进 AI 工厂规模的固件管理。
- Cluster API Provider for NVIDIA Infrastructure Controller:加速裸机部署和租户入驻,将原始 AI 硬件在数小时而非数天内转化为可投入生产的集群。
这些开源组件源自 NVIDIA 运营 NVIDIA DGX Cloud 的经验,使云提供商和软件合作伙伴能够将 AI 工厂能力直接集成到其多租户平台中。
开发者可以访问 DSX AI Factory Github 页面 来探索 NVIDIA DSX AI 工厂平台的新增和既有开源软件组件并做出贡献。
NVIDIA 与超大规模云服务商发布面向下一代 AI 工厂的开放标准
AI 基础设施要在全球范围内扩展,不仅需要先进的硬件,还需要整个行业都能赖以构建的共同基础。
在 OCP 上,NVIDIA 与 AMD、Google 和 Meta 共同发布了一项新的开放规范,确立了这一基础。 开放数据中心规范 v0.7 为下一代 AI 工厂设施设计定义了统一蓝图——从电力架构到散热基础设施再到物理布局。
由 Google、Meta、Microsoft 和 NVIDIA 发布的 OCP 电网韧性规范,确立了大规模 AI 基础设施在电网扰动期间应如何表现:保持连接、自动响应,并在不到两秒内恢复到接近满载的状态。
随着这些标准现在开放,全球制造商有了共同的构建目标。设备制造商、托管服务提供商和数据中心运营商可以开始设计、制造和交付为全球在建 AI 工厂提供动力的基础设施层——而无需等待个别客户的专有规范。
这些规范与 NVIDIA DSX 参考设计兼容,为两项规范提供了经过验证、可部署的实现,从设施布局和电力架构到实时监控并响应电网信号的软件。对于构建 Vera Rubin AI 工厂的运营商而言,从开放社区标准到运行中的系统之间如今有了直通路径。
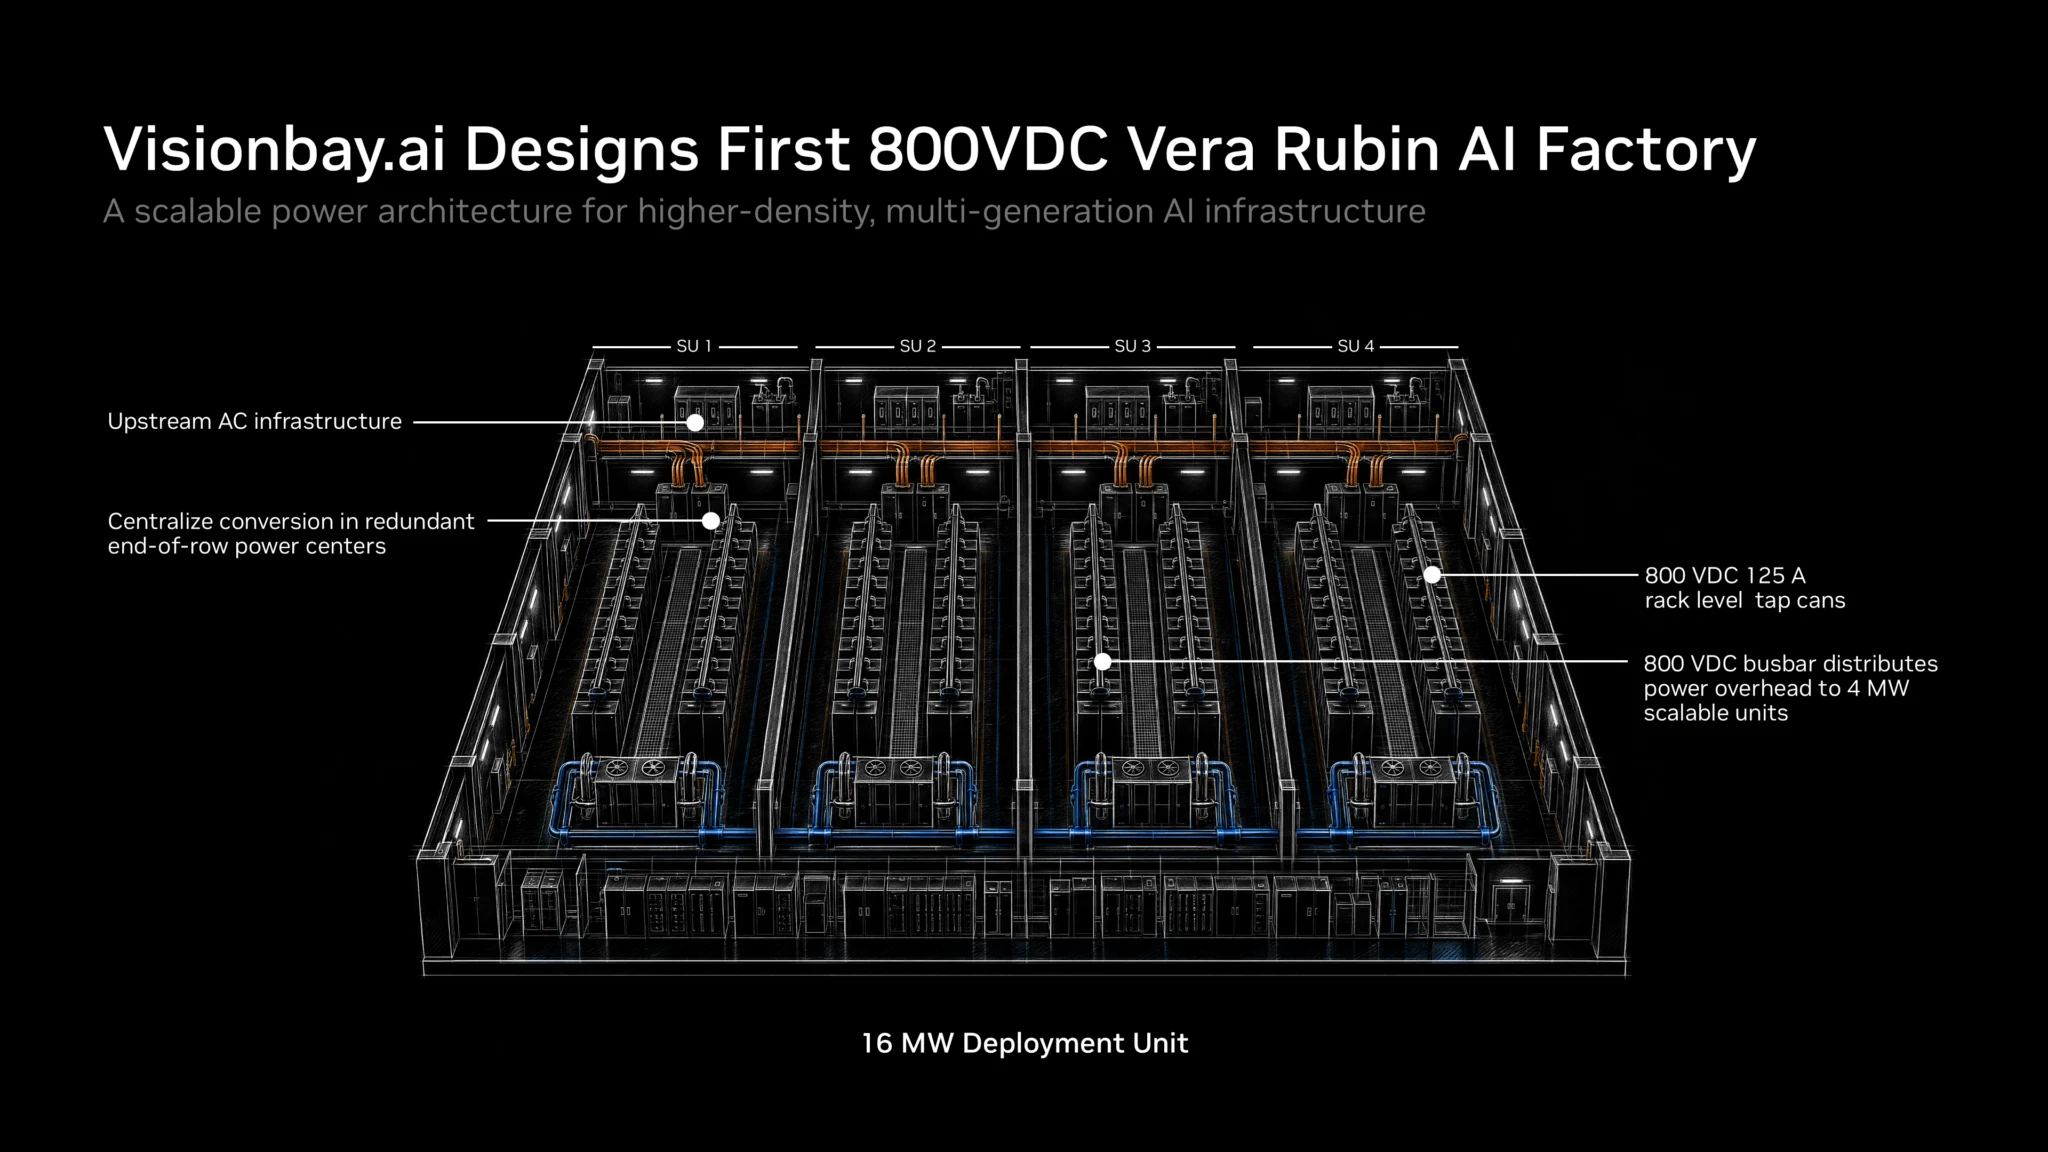
Visionbay.ai 为 Vera Rubin 时代设计 800VDC AI 工厂
随着 AI 工厂规模更大、能力更强,一个挑战笼罩着它们所有:为驱动下一代 AI 的加速计算系统提供足够的电力。
在 OCP 上,Visionbay 公布了 K-1 的计划,这是一个围绕 800 VDC 架构 设计、并为未来 NVIDIA Vera Rubin 部署而打造的下一代 AI 工厂平台。该项目将 NVIDIA 的 800 VDC 参考架构与 Vertiv 的电力和散热技术相结合,为高密度 AI 基础设施创建可扩展的基础。
该设计应对了行业日益严峻的挑战。随着AI训练、推理和推理工作负载的扩展,机架功率密度持续上升。传统的低压配电越来越难以扩展,需要更多的铜材、更多的布线和更多的电力转换设备。
通过采用 NVIDIA 的 800 VDC 架构,K-1 为更高密度的 AI 基础设施开辟了道路,同时保留了对现有部署的灵活性。该平台并非要求在第一天就完成全面转型,而是设计为在 800 VDC 配电能带来最大效益的地方逐步引入,帮助运营者为未来几代加速计算做好准备,而无需对设施进行大规模改造。
该架构围绕集群级电力中心设计,这些电力中心集中进行 AC 到 DC 的转换,并将 800 VDC 分配到更靠近计算资源的位置。这种方法简化了下游供电,支持模块化扩展,并为未来 AI 工厂的扩展创造了可重复使用的构建模块。
K-1 还体现了 NVIDIA AI 工厂背后的系统级设计理念,即电力、散热和计算协同设计。凭借对液冷基础设施、可扩展配电以及未来 Vera Rubin 级部署的支持,该项目展示了生态系统合作伙伴如何将 NVIDIA 的 AI 工厂架构转化为面向加速计算下一个时代、可实际部署的基础设施。
Meta 与 NVIDIA 通过 Spectrum-6 和 Multiplane 技术推进 AI 网络
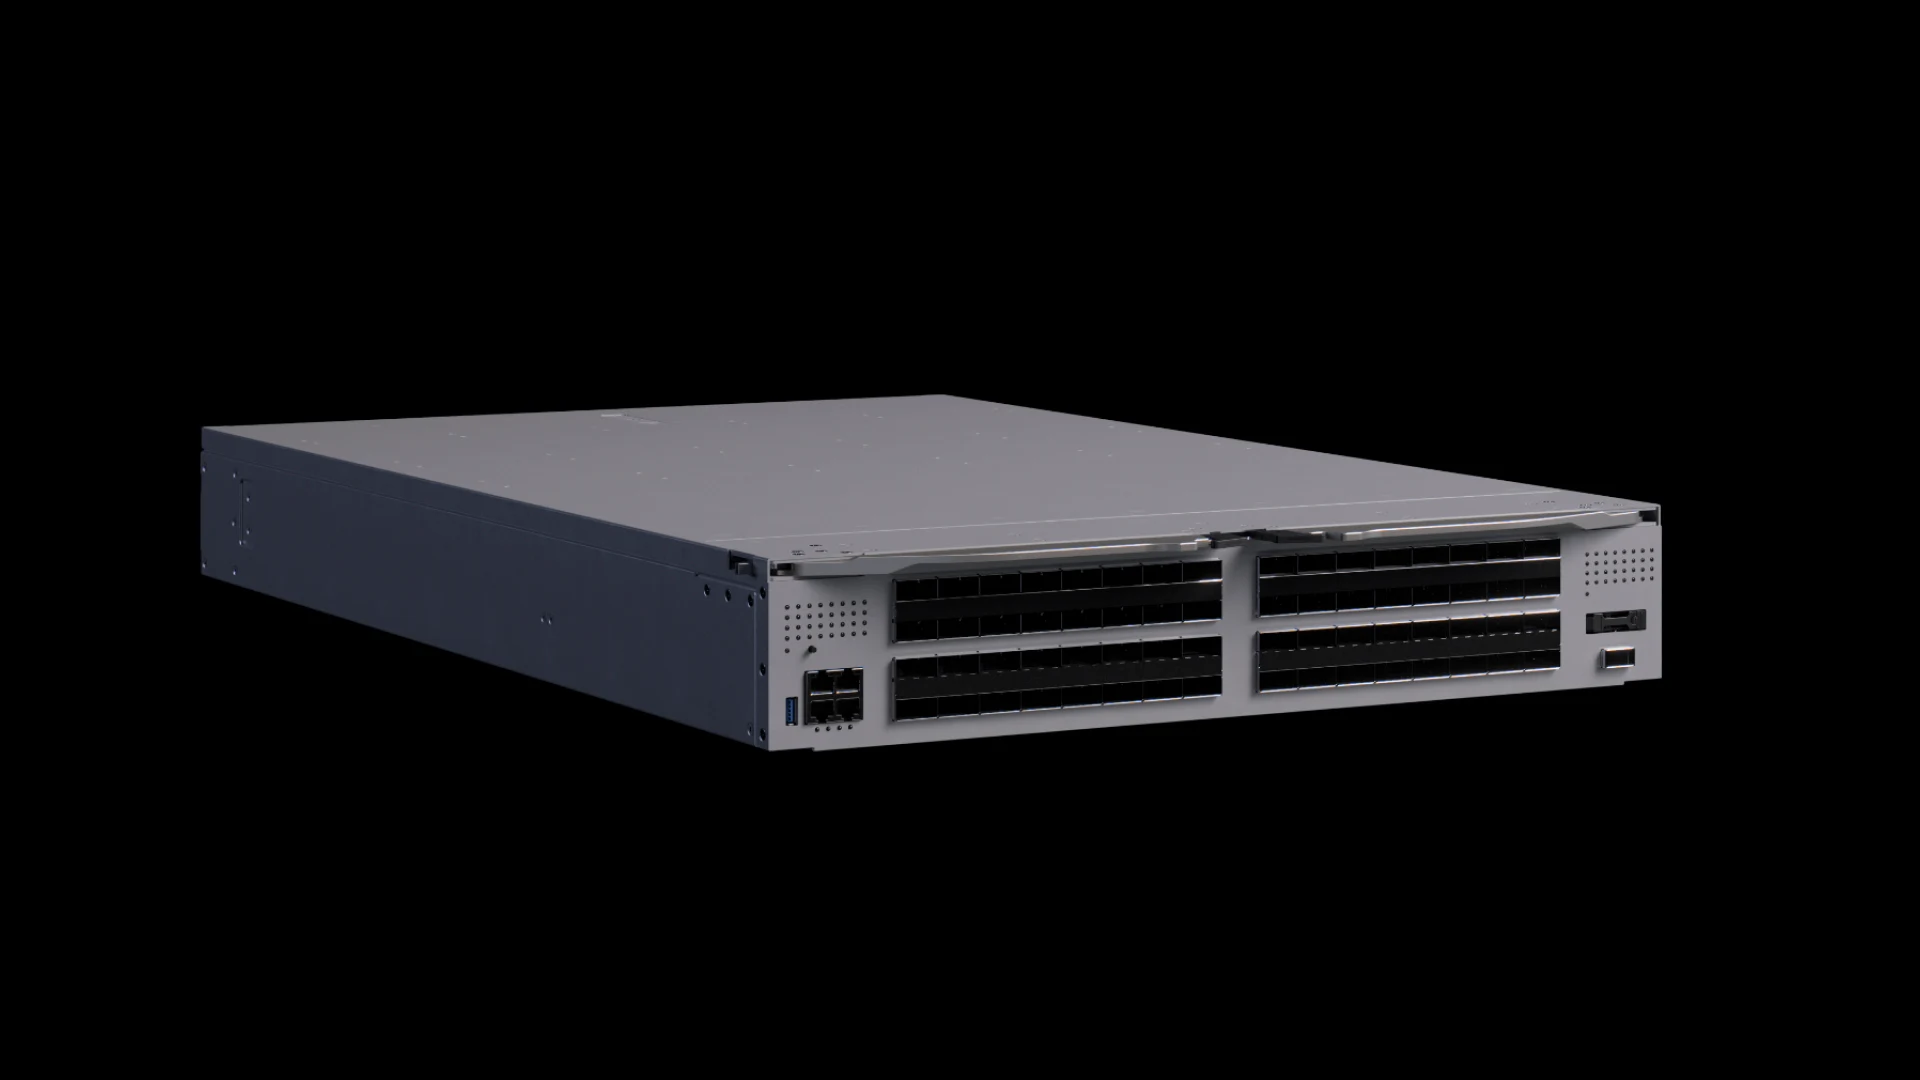
在此次活动上,Meta 和 NVIDIA 宣布 Meta 将采用 NVIDIA Spectrum-6 102.4Tb/s 以太网交换机,在开放网络上构建更大、更高性能的 NVIDIA Vera Rubin AI 工厂。
Spectrum-6 的交换容量和每通道带宽是 Spectrum-4 的两倍,并提供每通道 200G 的无损以太网 AI 结构,具有高有效带宽和性能隔离能力,可防止一个作业的流量拖慢另一个作业。
Meta 基于 Spectrum-6 的交换机 N-IceCube 可插入 Meta 的 100T 液冷机架 IcePack。N-IceCube 运行 Facebook 开源交换系统(FBOSS),这是 Meta 贡献给 OCP 的开源网络操作系统,用于支持超大规模环境下的高效组网。
FBOSS 构建于交换抽象接口(Switch Abstraction Interface,NVIDIA 参与开发的一项 OCP 标准)之上,提供了一种独立于厂商的交换机硬件控制方式。这些技术共同支持超过 100,000 个 GPU 的智能体 AI 工厂,用于训练和服务庞大的 混合专家(mixture-of-experts) 模型。
此次公告标志着双方合作的下一步,该合作将 Meta 在超大规模环境下运营 AI 基础设施的经验与 NVIDIA 的网络技术相结合。
这一合作的核心是 Spectrum-X Multiplane 技术,由 Spectrum-6 交换机和 ConnectX-9 SuperNIC 实现。Multiplane 在硬件中将 GPU 流量分布在多达八个独立的网络平面上,使 AI 工厂能够以更少的交换层级和更低的基础设施成本扩展到超过 100,000 个 GPU。GPU 之间的多条路径提升了网络利用率和弹性:当某个组件发生故障时,流量会转移到其余平面上,使 GPU 保持高产出、AI 应用持续运行,即使带宽有所降低。
Meta 和 NVIDIA 通过部署经验和快速工程迭代共同努力增强这种弹性。两个团队在本地和云环境中验证了这些改进。
Meta 数据中心与 AI 网络高级总监 Omar Baldonado 表示:“我们很高兴与 NVIDIA 紧密合作,使多平面网络结构在运营上可扩展且高性能,这对我们自己的基础设施建设以及我们的联合云合作伙伴来说都是一项关键要求。将 FBOSS 扩展到 Spectrum ASIC 上,意味着我们可以在整个网络结构中运行相同的软件栈,而 Meta 新推出的基于 Spectrum 的交换机 N-IceCube 则将其带入 Icepack——我们用于 scale-out 的液冷 102.4T 网络机架,用于连接我们机群中即将推出的新一代加速器。”
Meta 和 NVIDIA 正共同开发一种其他 AI 基础设施运营者可以采用的架构和运营手册,将来自严苛生产工作负载的经验转化为更具可扩展性、弹性和效率的 AI 工厂。
NVIDIA 与 Cisco 通过 USFP 重新定义 AI 工厂规模的可插拔光模块
随着 AI 工厂规模扩大以支持更大的模型和激增的推理需求,基础设施栈的每个组件都必须提供更高的性能、效率和简洁性——直到网络连接本身。
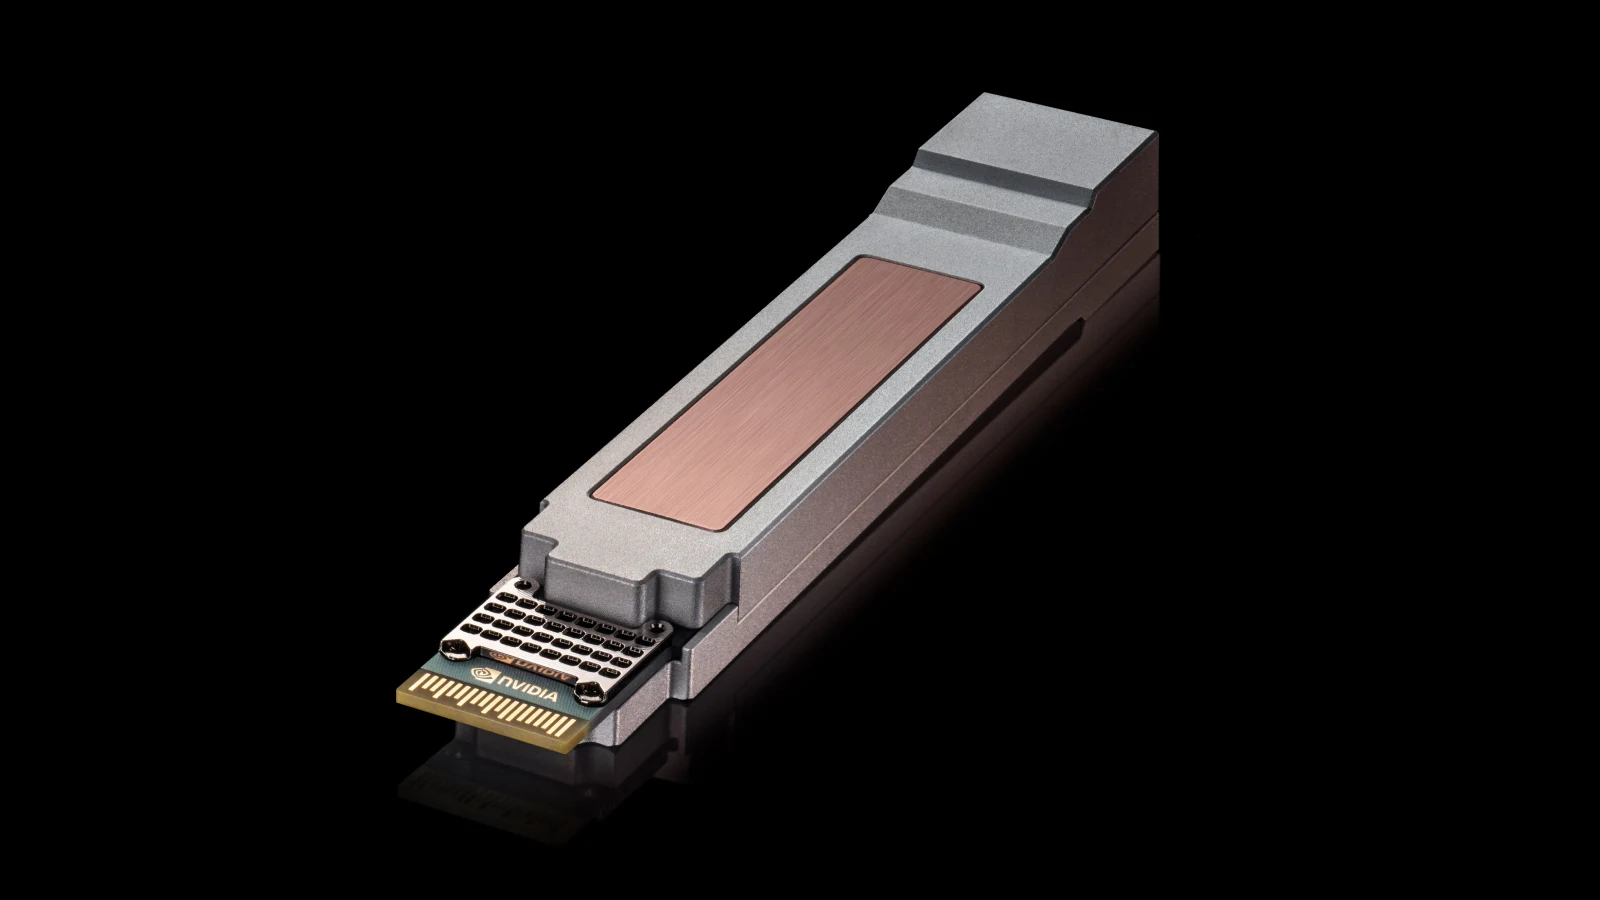
在 OCP 上, NVIDIA 和 Cisco 宣布了 USFP 计划 ,这是一种新的光可插拔收发器模块外形规格,旨在帮助 AI 工厂建设者扩展下一代 AI 网络结构,同时提升带宽密度和能效。
USFP 的占用面积与广泛采用的每通道 200Gb/s 的 OSFP 外形规格大致相同,将提供通往每通道 400Gb/s 网络的路径,并将扩展一种已在多代数据中心网络中被证明可行的基于收发器的部署模式。USFP 配备 16 个全双工通道,并计划扩展到多达 32 个通道,将提供传统每通道 200Gb/s 可插拔光模块四倍的带宽密度。
其结果是能够在不增加会增加延迟、功耗和复杂性的网络层级的情况下连接更多计算资源。
这一全新外形规格专为下一代AI工厂的规模和效率需求而设计,在支持更高带宽网络架构的同时,保留了使可插拔光学器件成为现代数据中心主流的灵活性和可维护性。它还将带来约1.3倍的能效提升,帮助运营商以更少的能耗传输更多的数据。
为推动开放生态系统,NVIDIA和Cisco正与TE Connectivity和Amphenol在笼架、连接器和模块方面展开合作,并计划通过社区主导的多源供应方式推进USFP的发展。这些公司正在携手为更具可扩展性、更高效、更可互操作的AI工厂网络奠定基础。
Google Falcon传输协议支持NVIDIA ConnectX-10以实现可互操作的AI网络
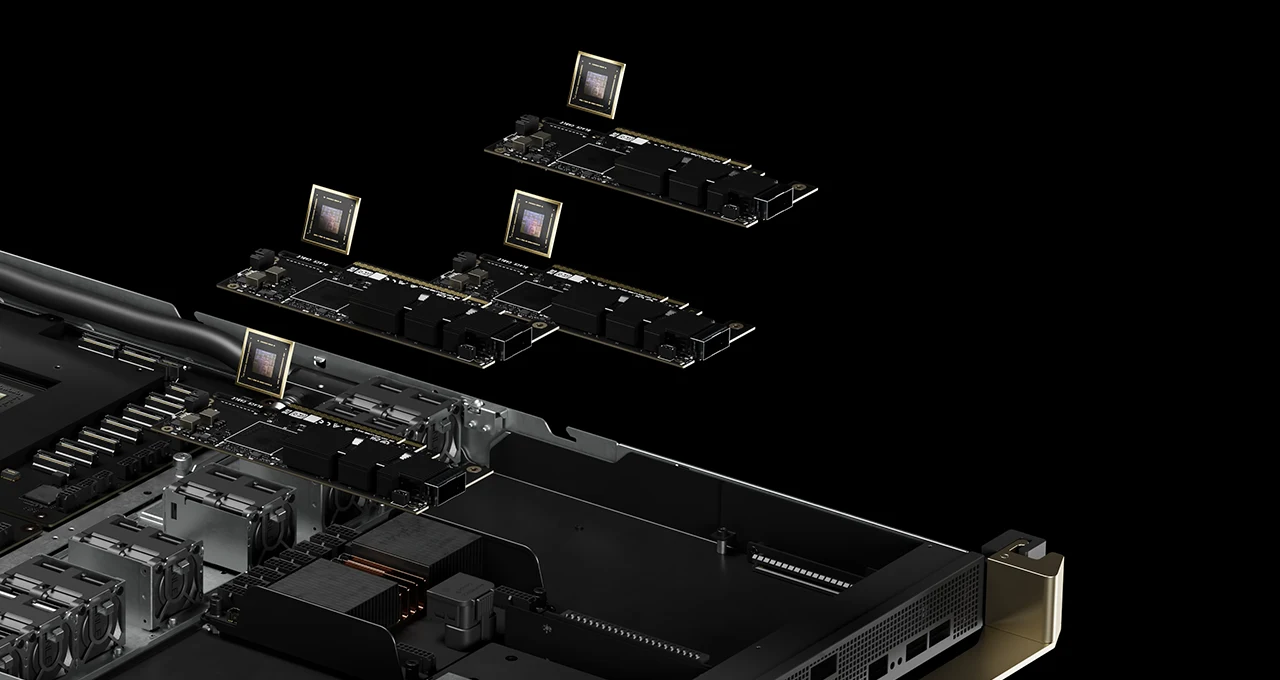
NVIDIA和Google还宣布,未来的NVIDIA ConnectX-10 SuperNIC和BlueField DPU将支持Falcon Transport,帮助提升大规模AI基础设施的网络效率。
Falcon是一种旨在通过以太网网络可靠传输数据的传输协议,而以太网在拥塞时可能会丢包。它通过多路径负载均衡、可编程拥塞控制、硬件丢包恢复和每连接安全性来支持AI和存储工作负载。
此次合作将NVIDIA硬件加速与DOCA软件相结合以实现Falcon,并将NVIDIA网络技术扩展至Google的数据中心传输。NVIDIA和Google的NIC可以通过共同的传输协议进行通信,同时应用程序保留标准的RDMA编程接口。
通过将流量分发到多条路径、适应拥塞、恢复丢弃的数据包以及保护连接,Falcon帮助工作负载更好地利用可用带宽,并在以太网网络架构扩展时保持可预测的性能。
欲了解更多信息,请参加 NVIDIA在OCP上的活动.