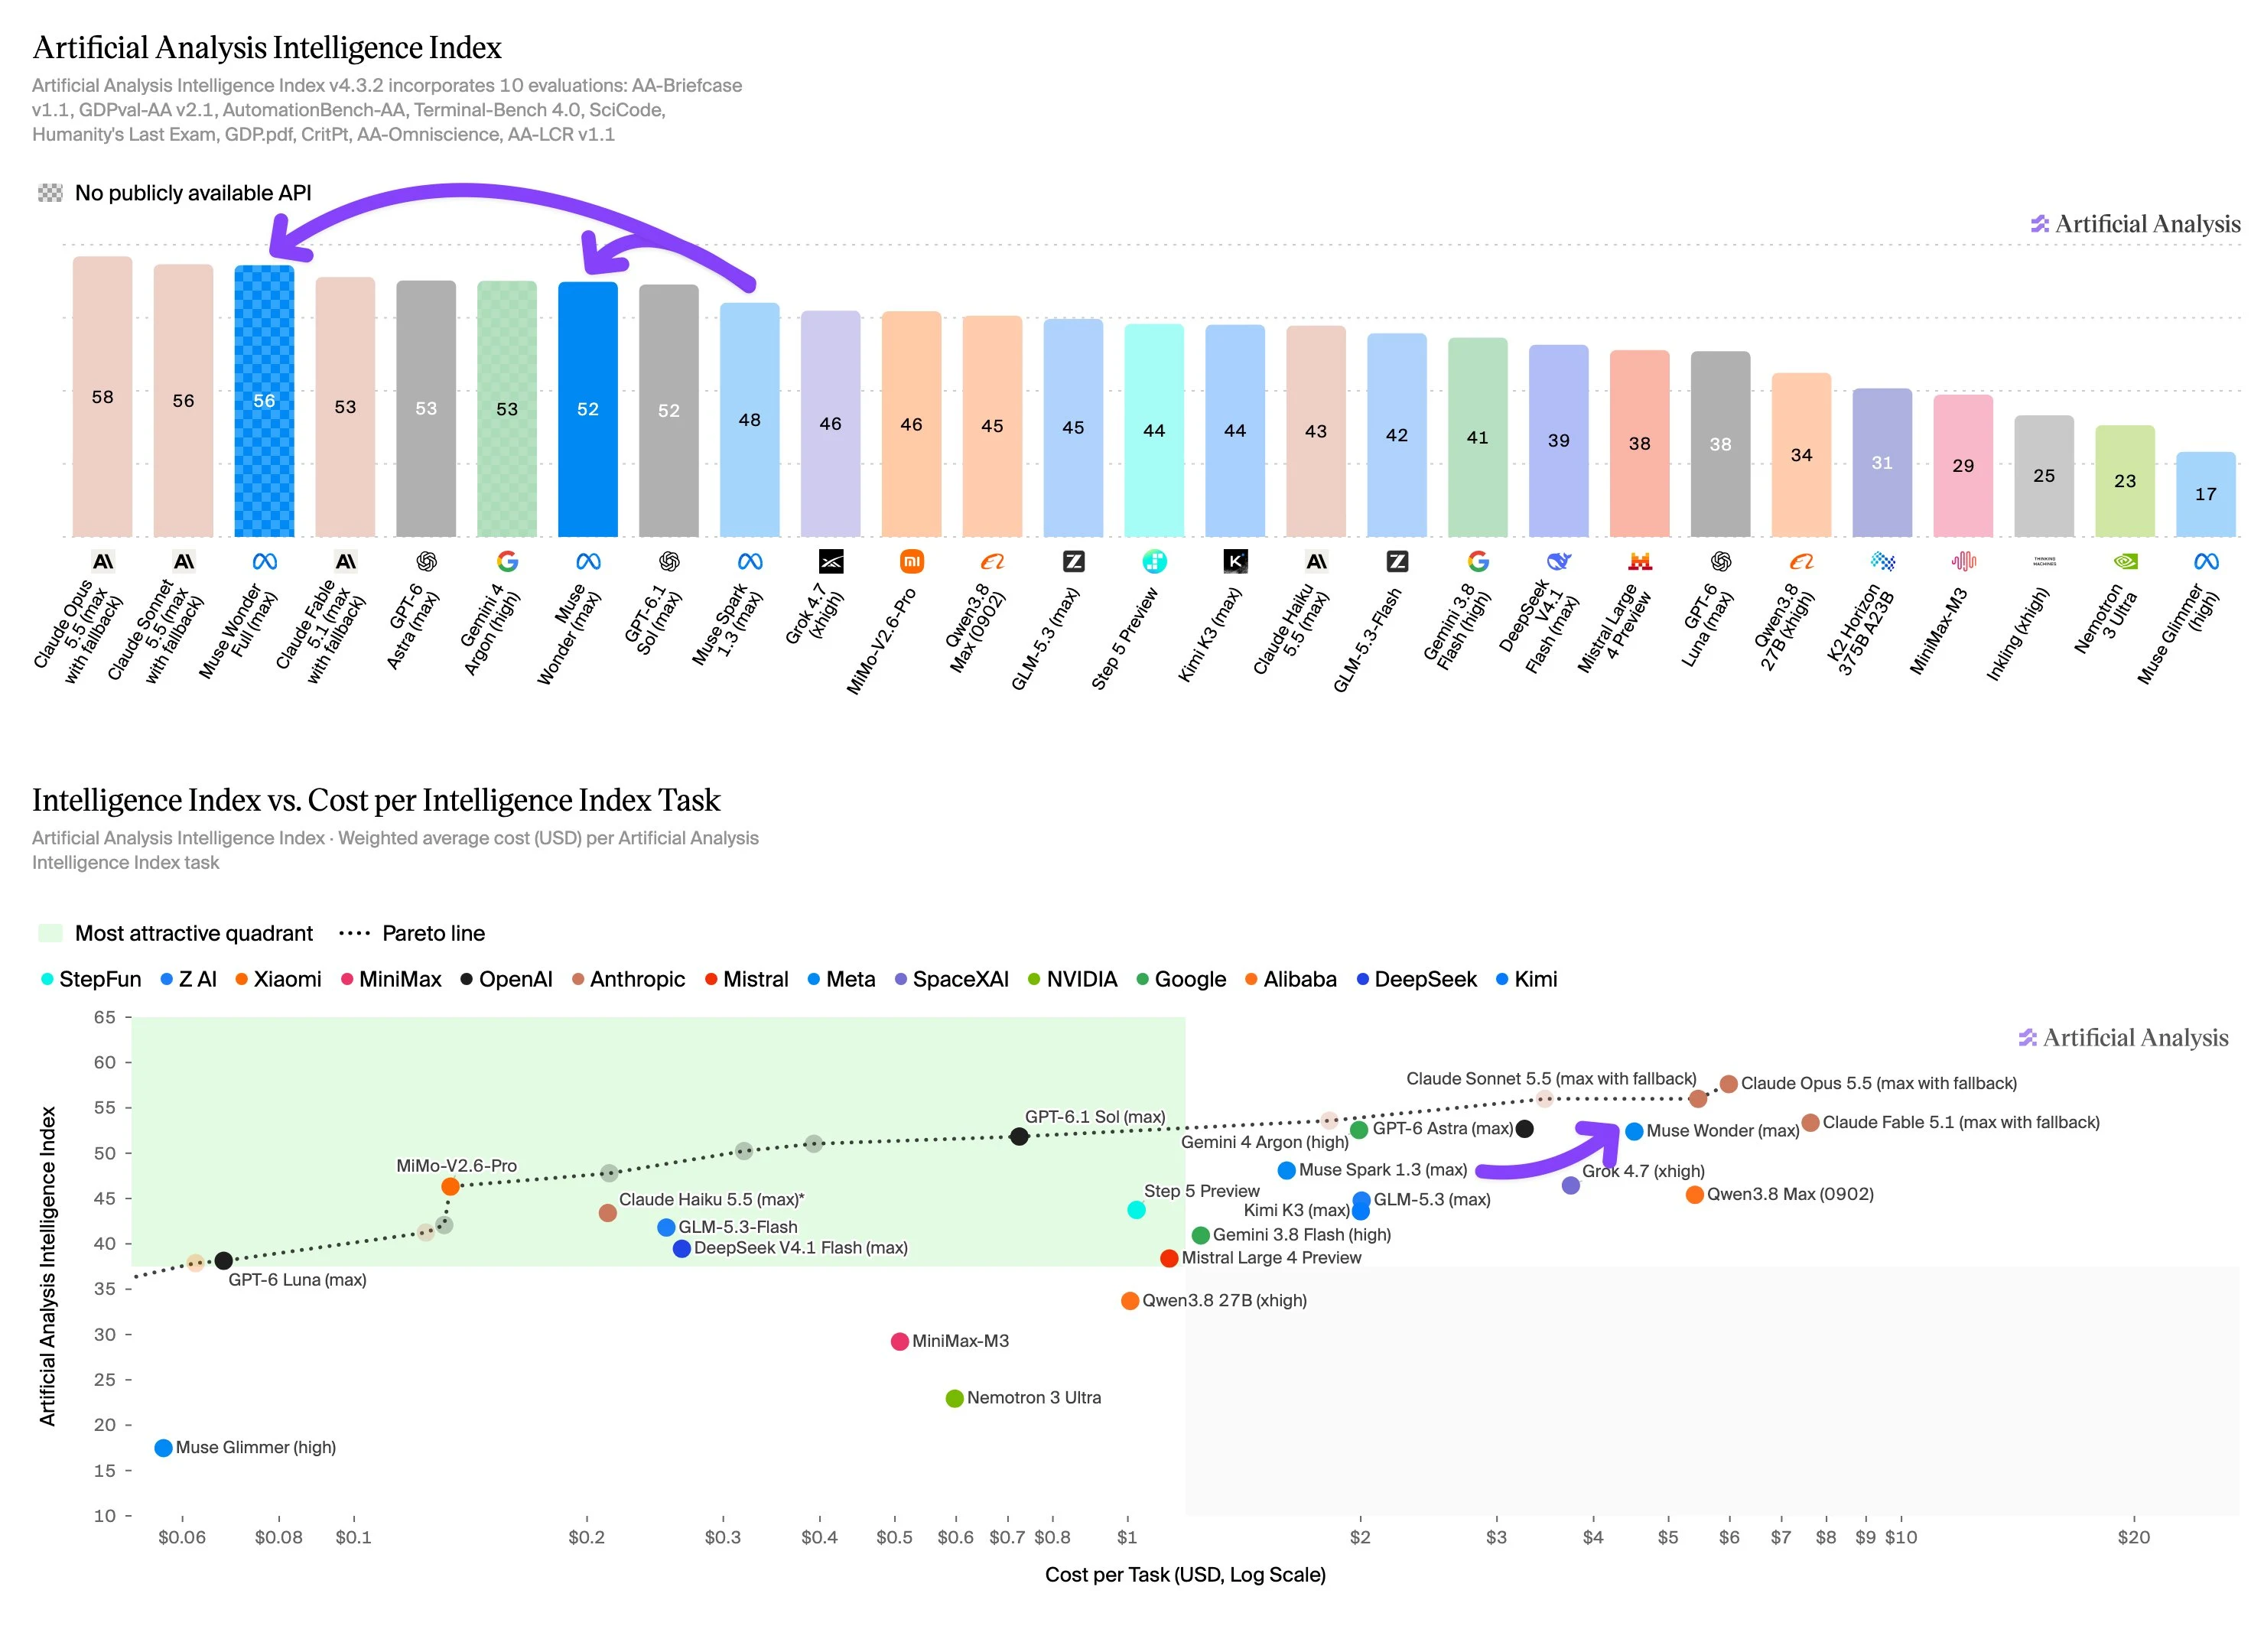
Meta 已发布 Muse Wonder 和 Muse Wonder Full,在最大推理强度下 Artificial Analysis Intelligence Index v4.3 得分分别为 52 和 56 - 相较于得分为 48 的 Muse Spark 1.3(max),两者均有实质性提升,且发布间隔仅为 6 周
Muse Wonder 可供使用 Meta 第一方 API 的用户使用,而 Muse Wonder Full 目前仅对 Muse Code 用户开放。Meta 指出,两款模型均专为个人和专业智能体用途而设计
祝贺 @AIatMeta、@finkd 和 @alexandr_wang 的发布!
核心要点:
➤ 两款模型在整体 Intelligence Index 得分上均表现出实质性跃升。Muse Wonder Full(max)在全部十项 Intelligence Index 评估中均优于 Muse Spark 1.3(max),提升 8 分至 56 分。最大提升出现在智能体评估中:Terminal-Bench 4.0(+24 分,33% 至 57%)、GDPval-AA v2.1(+176 Elo,1681 至 1857)以及 AA-Briefcase(+148 Elo,1581 至 1729)。Muse Wonder(max)提升 4 个 Intelligence Index 分数,达到 52 分,相比 Muse Spark 1.3(max)在 Terminal-Bench 4.0(33% 至 52%)和 AutomationBench-AA(58% 至 68%)上有显著改进
➤ Muse Wonder Full(max)在十项 Intelligence Index 评估中的六项中位列前三,在智能体知识工作和科学推理方面尤为出色。在智能体知识工作方面,它在 GDP.pdf(33%)上以微弱优势领先,在 GDPval-AA v2.1(1857 Elo)上排名第 2,在 AA-Briefcase(1729 Elo)和 AutomationBench-AA(71%)上均排名第 3。在科学推理方面,它以 33% 登顶 CritPt 排行榜,并在 SciCode 上以 63% 排名第 3。这延续了 Muse Spark 1.3(max)的相对优势,后者在这两个领域同样表现出色
➤ 两款模型的输出 token 使用量均低于 Muse Spark 1.3(max)。Muse Wonder(max)和 Muse Wonder Full(max)每个 Intelligence Index 任务各使用约 54k 输出 token,比 Muse Spark 1.3(max,60k)降低约 10%。这一使用量低于智力相近的模型 Gemini 4 Argon(high,62k)和 Claude Fable 5.1(max w/ fallback,78k),但高于 GPT-6.1 Sol(max,38k)和 GPT-6 Astra(max,27k)。Muse Wonder Full(max)每个 Intelligence Index 任务使用的输入 token 比 Muse Wonder(max)少 16%(6.44M 对 7.69M),这意味着它既更智能又更具 token 效率
➤ Muse Wonder(max)的每任务成本高于大多数智力相近的模型。尽管输出 token 使用效率高,但高昂的 API 定价(每百万输入 token 4 美元,每百万输出 token 20 美元)以及较高的输入 token 使用量(每任务 7.69M)使 Muse Wonder(max)的成本达到每个 Intelligence Index 任务 4.52 美元。这低于 Claude Fable 5.1(max w/ fallback,7.63 美元)、Claude Opus 5.5(max w/ fallback,5.98 美元)和 Claude Sonnet 5.5(max w/ fallback,5.46 美元),但高于 GPT-6 Astra(max,3.26 美元)、Gemini 4 Argon(high,1.99 美元)、GPT-6.1 Sol(max,0.72 美元)及其前代 Muse Spark 1.3(max,1.60 美元)。Muse Wonder Full 目前尚未提供按 token 定价,因此现阶段无法估算每任务成本
➤ 两款模型在编程智能体性能上均取得显著提升。Muse Wonder Full 在最大推理强度下于 Muse Code 中的 Artificial Analysis Coding Agents Index 得分为 68,与搭配 Sonnet 5.5 的 Claude Code(max,68)和 Opus 5.5(max,66)并列。Muse Wonder(max)得分为 63。相较得分为 54 的 Muse Code with Muse Spark 1.3(max),这是实质性提升
两款新模型的其他细节:
➤ 上下文窗口:各为 1M token,与 Muse Spark 1.3 相比无变化
➤ 定价:Muse Wonder 为每 1M token 输入 4 美元 / 缓存输入 0.20 美元 / 输出 20 美元。Muse Wonder Full 的按 token 定价尚未公布
➤ 输入模态:文本、图像、视频和音频
➤ 输出模态:文本
➤ 可用性:Muse Wonder 在发布时即可通过 Meta 第一方 API 和 Muse Code 使用,而 Muse Wonder Full 仅对 Muse Code 用户开放