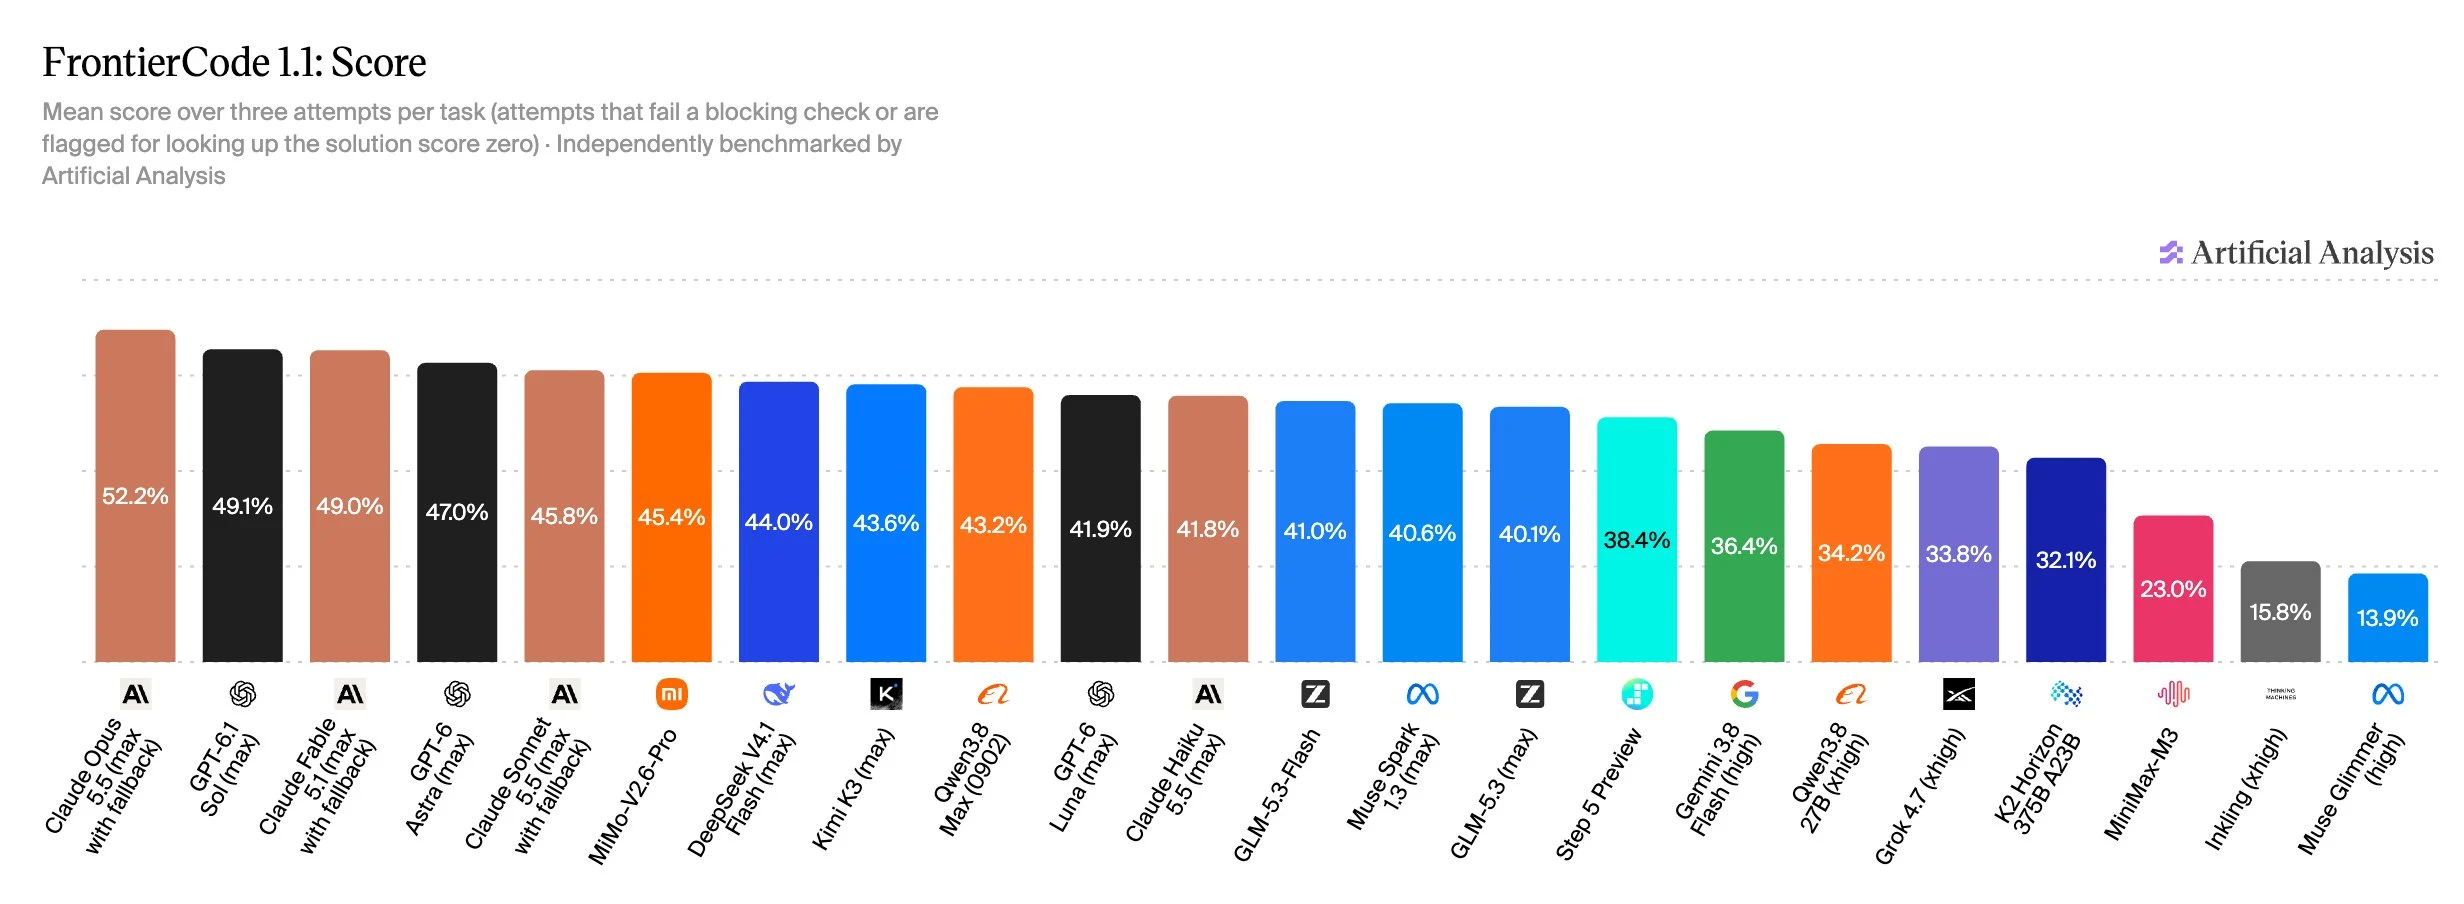
我们正在推出 FrontierCode 1.1 的排行榜,这是 Cognition 提供的私有评估项目,该评估通过实际完成编程任务的方式对模型进行测试,这样才可能被真实世界存储库的管理人员合并使用。
@cognition 在2026年6月发布了FrontierCode,并在7月将其更新为1.1版本。Cognition由开源维护者构建数据集,这些维护者每个任务花费了超过40小时。每个任务都要求智能体对真实的开源仓库进行修改,然后检查单元测试和定性测试,以确认维护者在进行合并修改时所需的条件是否满足。
我们使用 FrontierCode 1.1 Main 版本运行测试中的 150 项任务中的核心 100 项任务,并借助 Stirrup 开源参考框架来实现不同模型之间的公平比较。所有任务均为私密处理,以避免污染数据。每次尝试都会根据阻塞与非阻塞标准进行评分:如果任何阻塞检查失败,得分为零;如果所有检查都通过,则得分为 70% 至 100% 之间。
与其他编程评估不同,FrontierCode 基于实际使用情况来全面评估成功程度。模型需要通过单元测试,但还会被评估是否出现过度修改、大差异、在无关范围内修改文件或添加无用的测试等行为。我们认为这种方式在当前情境下很有价值:模型现在在编程任务上非常能力强,但其修改内容仍可能需要大量清理工作,否则维护人员才会将其合并。
关键要点:
➤ 领先模型仍然有超过 40% 的时间失败:Claude Opus 5.5(最大 fallback 表现)在 58% 的尝试中成功通过阻碍项后,得分为 52%。在我们评估的 100 项任务中,有 9 项在任何尝试中都未被任何模型通过。
➤ 排行榜的顶部排列得非常紧密:六个实验室的九种模型得分都在43%到52%之间。MiMo-V2.6-Pro是排名最高的开放权重模型,得分为45%,其次是DeepSeek V4.1 Flash(最高)和 Kimi K3(最高),得分均为44%。
➤ GPT-6.1 Sol (最大版本) 在成本方面提供了最强大的性能:每个任务花费 0.81 美元,其得分为 49%,与 Claude Fable 5.1 (最大版本带备用方案) 相当。这意味着它的性能与领先的 Anthropic 模型相似,但每个任务的成本不到前者的十分之一。
感谢 @silasalberti、@ybenpan、@cl571128 以及 Cognition 团队的其他成员共同开发 FrontierCode,并与我们合作将其应用于人工分析领域——我们很快会将 FrontierCode 加入我们的编程代理排行榜中。