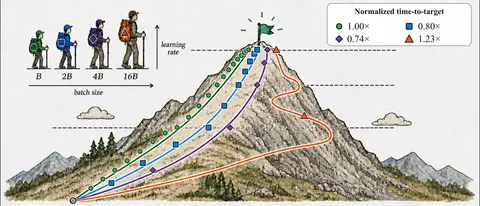
Eine größere Batch ermöglicht es, bei jeder Aktualisierung mehr Sequenzen zu verarbeiten und dadurch mehr parallele Rechenressourcen zu nutzen; bei festem Sample-Budget verringert sich jedoch auch die Anzahl der möglichen Aktualisierungen des Modells. Wann vergrößert man im verstärkenden Lernen die Batch so, dass sich die tatsächliche Zeit bis zum Erreichen der Zielleistung verkürzt? Bei großen Sprachmodellen muss zudem berücksichtigt werden, dass Trainings-Trajektorien online erzeugt werden müssen und dass Erzeugung und Training unterschiedliche Anforderungen an die Rechenressourcen stellen. Wir haben einen analytischen Rahmen aufgebaut, der die bis zum Erreichen der Zielleistung benötigte Sample-Anzahl mit dem End-to-End-Durchsatz verknüpft: Nur wenn der Durchsatzgewinn die zusätzlichen Sample-Kosten übersteigt, beschleunigt eine größere Batch das Training. Daraus ergibt sich auch eine praktische Reihenfolge der Abstimmung: Zunächst den Bereich finden, in dem der Lerneffekt nach einer Änderung der Batch-Size annähernd unverändert bleibt, und dann innerhalb dieses Bereichs den Durchsatz optimieren. GRPO- und PPO-Experimente zeigen, dass nach einer Neuanpassung der Lernrate die Lernkurven unterschiedlicher Batch-Größen innerhalb eines bestimmten Bereichs beim Vergleich über die kumulierten Samples weitgehend übereinstimmen. Auf fester Hardware erhöht eine größere Batch den Erzeugungsdurchsatz um bis zum Faktor 2.29; unsere beste gemessene GRPO-Konfiguration verkürzte – ohne zusätzliche GPUs – die Zeit bis zum Erreichen desselben Validierungsziels um 29 %.