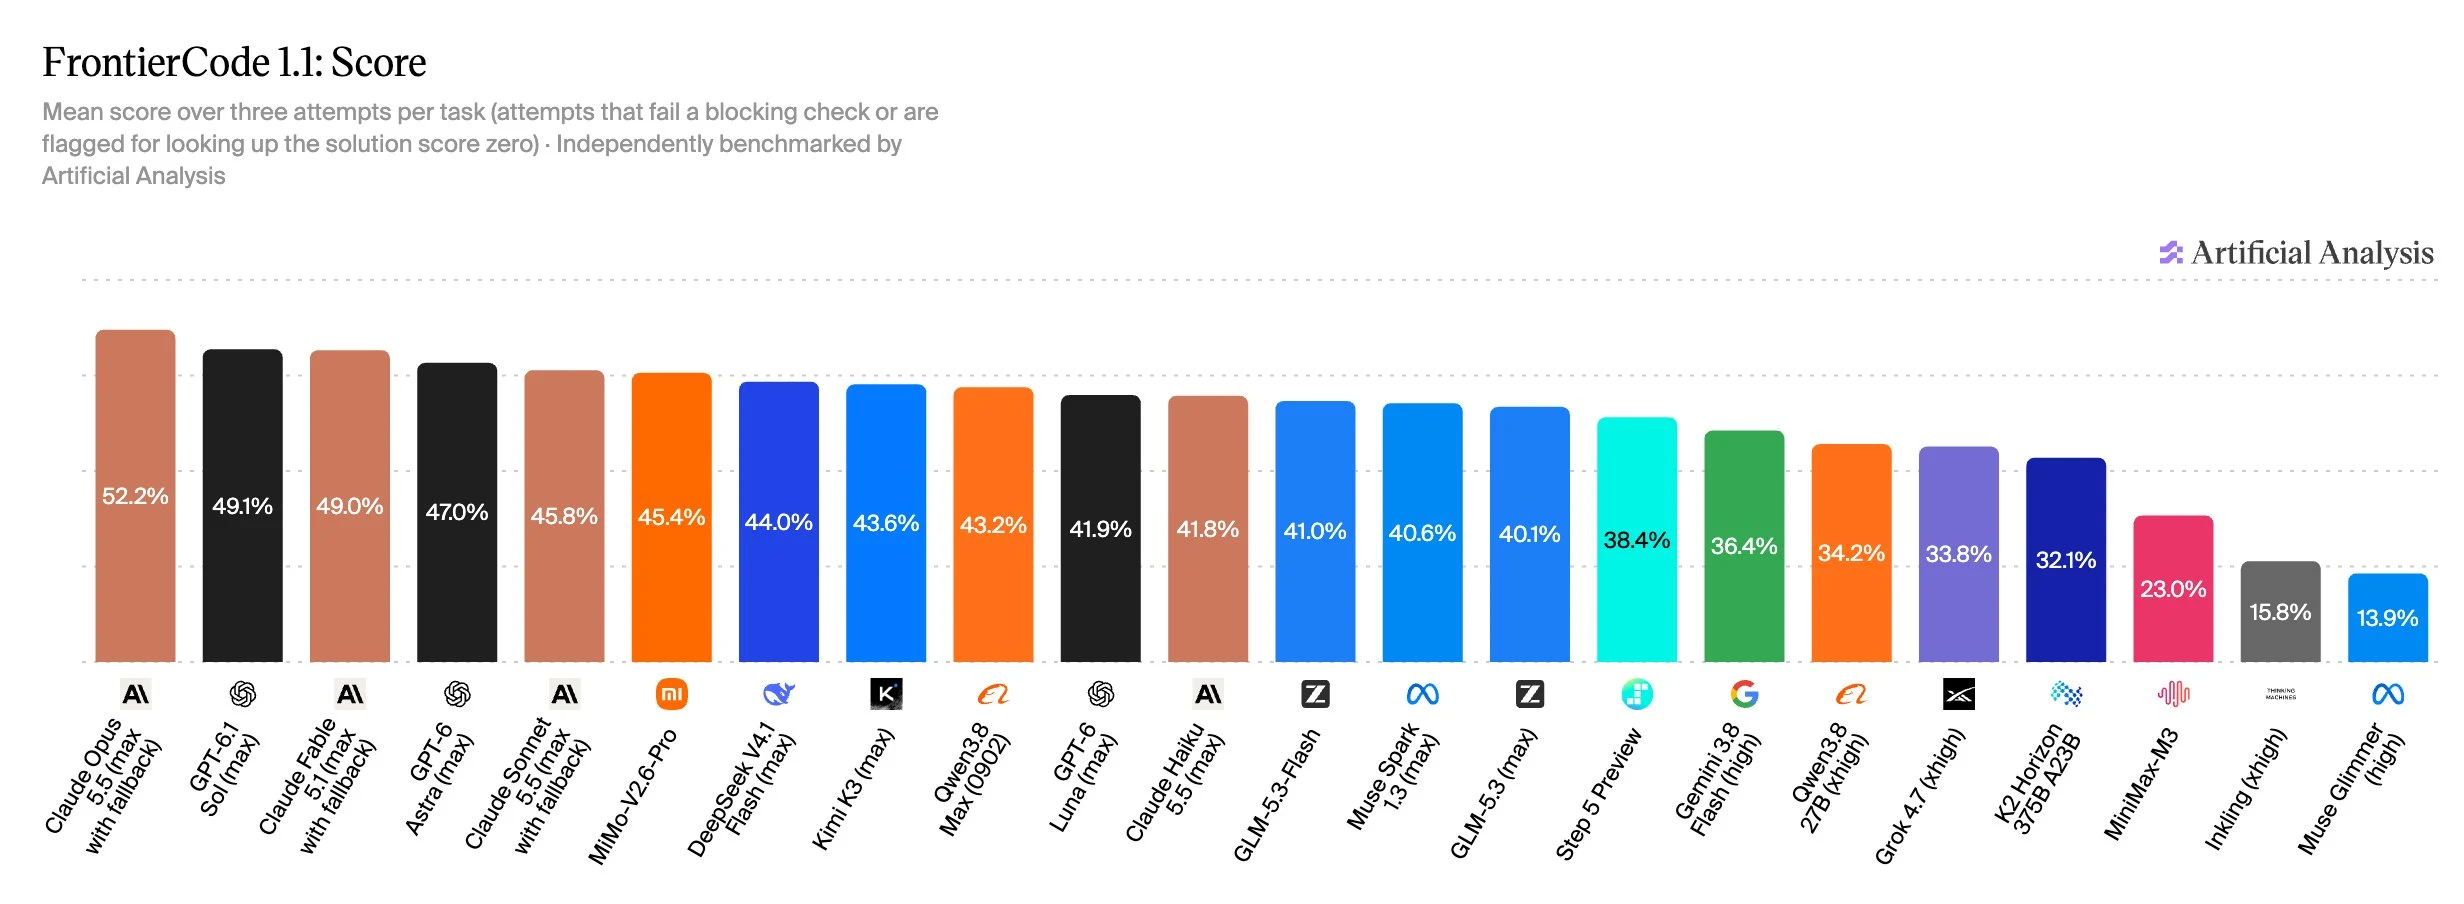
Nous lançons notre classement pour FrontierCode 1.1, une évaluation privée de Cognition qui teste les modèles en accomplissant des tâches de codage de manière à être effectivement intégrée par les maintaineurs de dépôres du monde réel.
@cognition a annoncé FrontierCode en juin 2026 et l’a mis à jour à la version 1.1 en juillet. Cognition a créé le jeu de données avec des mainteneurs open source qui ont passé plus de 40 heures par tâche. Chaque tâche exige que l’agent apporte des modifications dans un répertoire open source réel, puis vérifie les tests unitaires et les tests qualitatifs afin d’assurer que les mainteneurs seraient satisfaits de la fusion de ces modifications.
Nous utilisons FrontierCode 1.1 Main, le set principal de 100 tâches parmi les 150 tâches du benchmark, en utilisant notre harnais de référence open source Stirrup pour des comparaisons comparables entre les modèles. Toutes les tâches sont confidentielles afin d’éviter toute contamination. Chaque tentative est évaluée selon des critères bloquants et non bloquants. Une tentative qui échoue à l’un des tests bloquants obtient une note de zéro, tandis qu’une tentative qui les réussit toutes obtient une note comprise entre 70 % et 100 %.
Contrairement à d’autres évaluations de codage, FrontierCode offre une perspective plus globale du succès basée sur l’utilisation réelle. Les modèles doivent passer les tests unitaires, mais sont également évalués en fonction de comportements tels que des modifications excessives, des diffs importants, la modification de fichiers hors de leur domaine ou l’ajout de tests inutiles. Nous pensons que cette approche est utile dans le contexte actuel : les modèles sont désormais très capables pour les tâches de codage, mais leurs modifications nécessitent encore une nettoyage important avant qu’un mainteneur ne les fusionne.
Points clés :
➤ Les modèles leaders échouent encore plus de 40 % du temps : Claude Opus 5.5 (maximum avec fallback) se classe en tête avec un score de 52 % après avoir réussi les obstacles dans 58 % de ses tentatives. Neuf des 100 tâches n’ont pas été réussies par aucun des modèles évalués pour le lancement.
➤ Le sommet du classement est très dense : neuf modèles provenant de six laboratoires obtiennent des scores entre 43 % et 52 %. MiMo-V2.6-Pro est le modèle de poids ouvert leader avec 45 %, suivi par DeepSeek V4.1 Flash (max) et Kimi K3 (max) avec 44 %.
➤ GPT-6.1 Sol (max) offre les performances les plus fortes pour son coût : à 0,81 $ par tâche, il obtient une note de 49 %, équivalent à Claude Fable 5.1 (max) avec fallback. Cela signifie qu’il atteint des performances similaires aux modèles Anthropic leaders, pour moins d’un dixième du coût par tâche.
Merci à @silasalberti, @ybenpan, @cl571128 et au reste de l’équipe de Cognition pour avoir développé FrontierCode et collaboré avec nous afin de le mettre en place dans Artificial Analysis – nous travaillons à intégrer FrontierCode dans notre classement des agents de codage très bientôt.