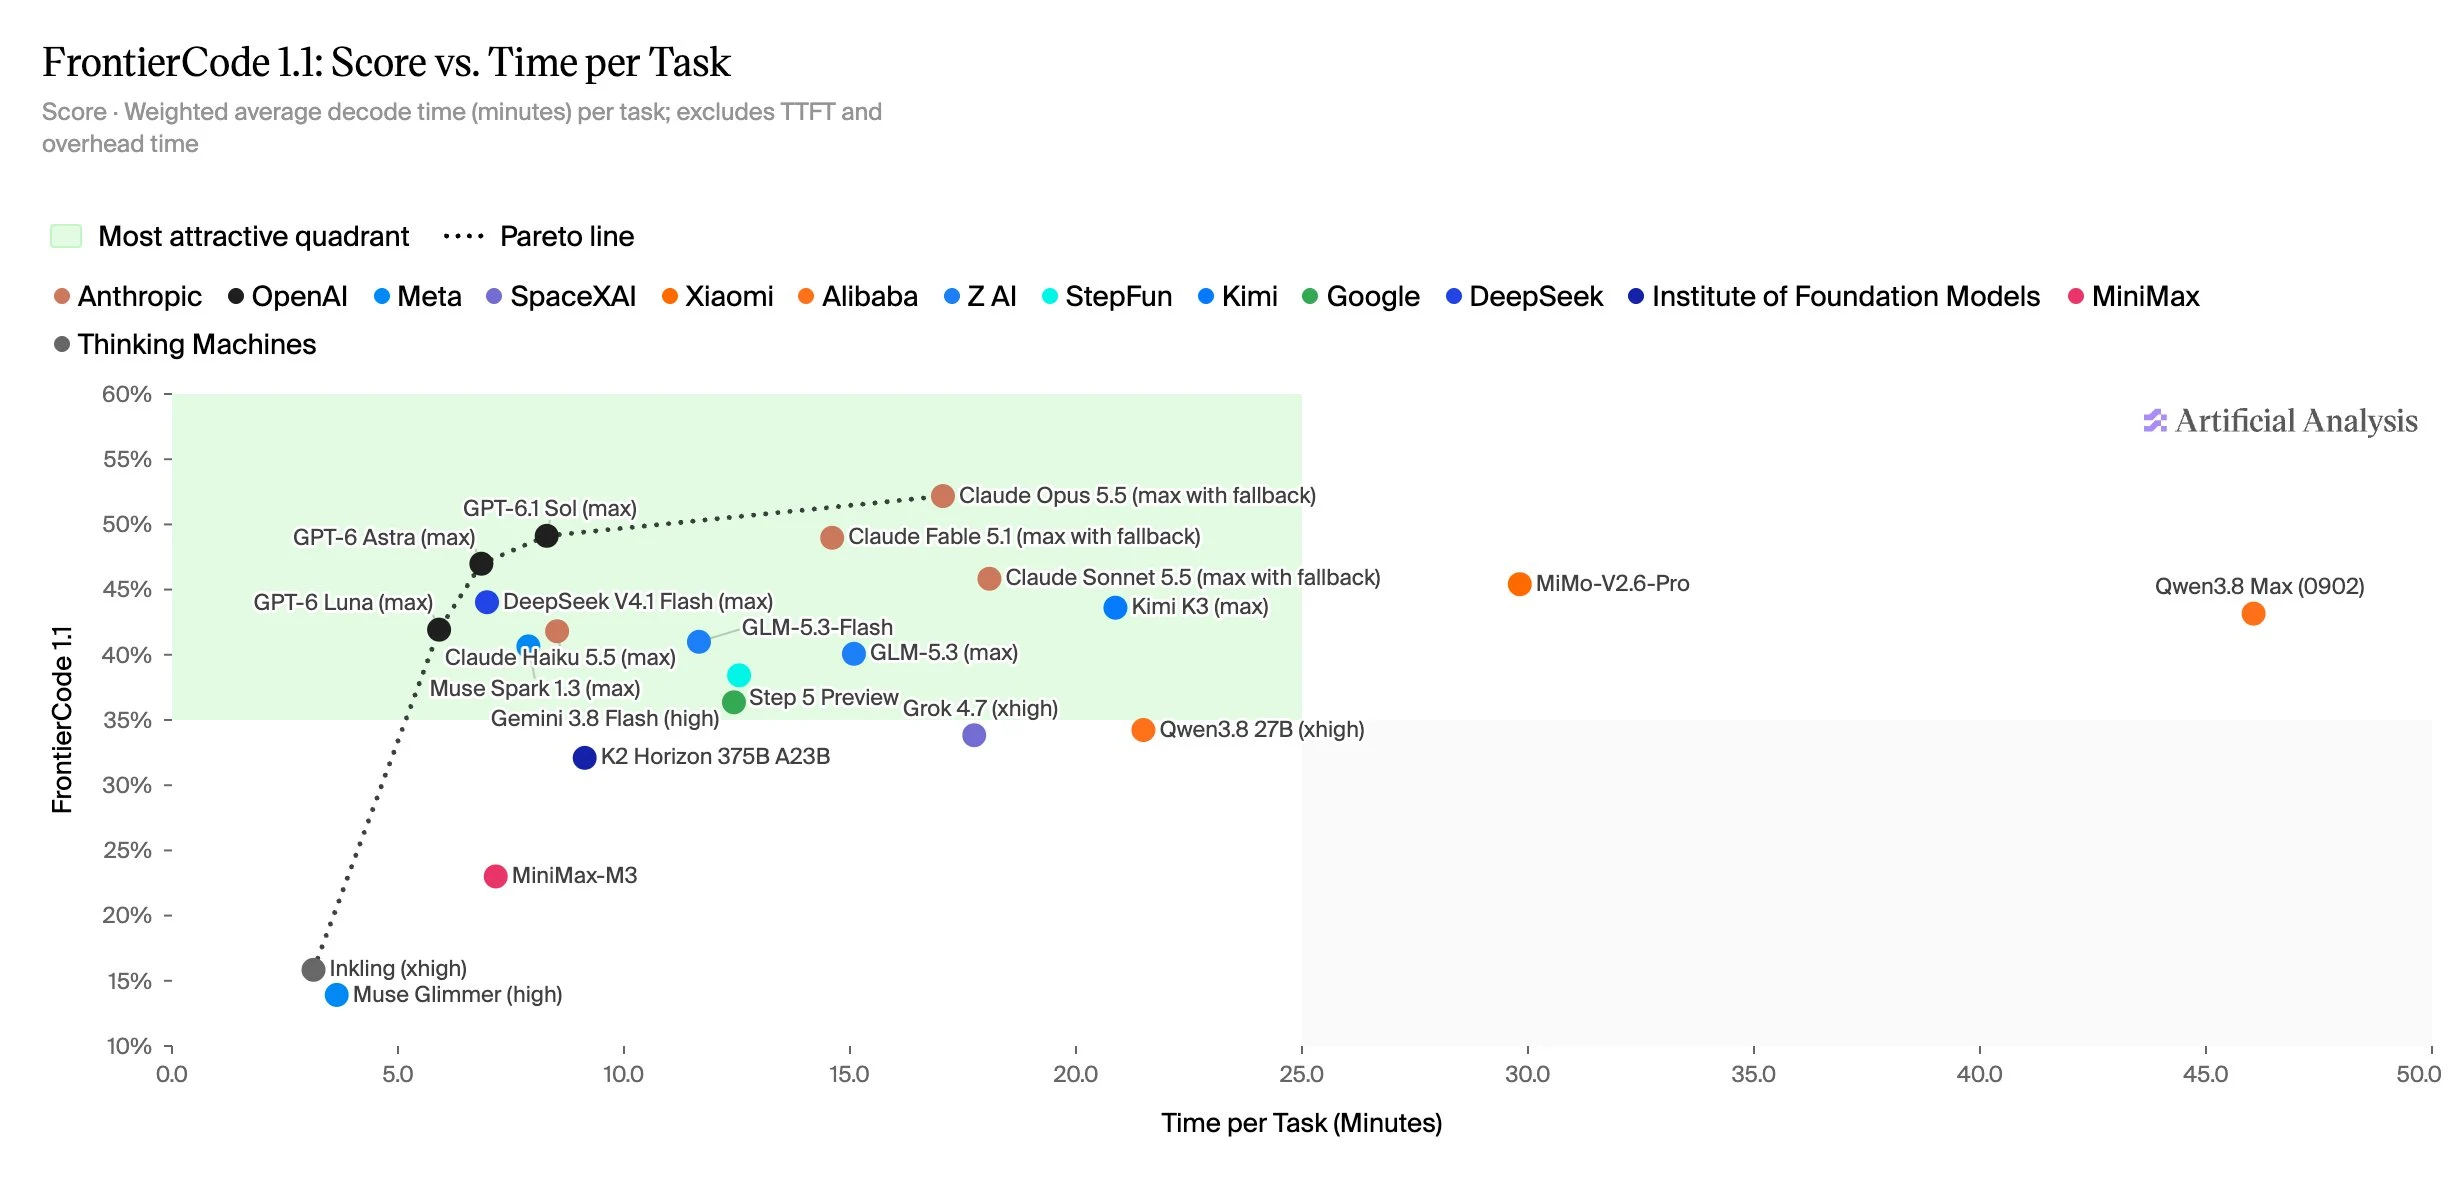
GPT-6 Luna (max), GPT-6 Astra (max), GPT-6.1 Sol (max) et Claude Opus 5.5 (max avec fallback) se situent sur la frontière de Pareto en termes de score et de temps par tâche. Nous estimons le temps par tâche à partir de l’utilisation des tokens de chaque modèle et de nos mesures de vitesse d’affichage en temps réel. Les modèles GPT-6 sont rapides car ils utilisent peu de tokens, soit 27 000 à 48 000 tokens d’affichage par tâche. DeepSeek V4.1 Flash (max) utilise environ 119k, mais est servi rapidement, avec une moyenne de ~7 minutes par tâche, soit environ 40 % du temps de Claude Opus 5.5 (max avec fallback) à ~17 minutes.