
Les charges de travail agentiques multi-tours s'appuient sur un contexte accumulé à mesure que l'agent raisonne, invoque des outils et intègre les résultats antérieurs. À chaque nouveau tour, le client renvoie l'historique de la conversation, y compris les instructions système, les invites précédentes, les résultats d'outils et les réponses du modèle, ce qui fait que le contexte croissant est traité de manière répétée. Dans la désagrégation prefill-decode (P-D), chaque requête est répartie entre des nœuds spécialisés : le nœud de prefill traite l'invite et construit son cache KV, puis le nœud de decode récupère ces blocs KV et génère la réponse.
Le service désagrégé conventionnel, cependant, ne transfère le cache KV que dans une seule direction : du nœud de prefill vers le nœud de decode. Ce flux unidirectionnel crée deux inefficacités pour les charges de travail multi-tours. Premièrement, après avoir généré une réponse, le nœud de decode conserve des entrées de cache KV pour l'invite et les jetons nouvellement générés. Lors du traitement du tour suivant, le nœud de prefill ne peut pas récupérer ces entrées, il doit donc recalculer les projections KV pour les jetons de la réponse précédente. Deuxièmement, le nœud de decode maintient l'état de la session alors que les nœuds de prefill ne le font pas, ce qui augmente la probabilité d'éviction du cache pour les sessions actives sur les nœuds de prefill. En cas d'échec complet du cache, le nœud de prefill doit recalculer les projections KV pour l'intégralité de l'historique de la conversation, y compris les instructions système, les requêtes utilisateur précédentes, les résultats d'outils et les réponses générées par le modèle. À mesure que la conversation s'allonge, ce travail redondant consomme davantage de capacité des accélérateurs et augmente le délai jusqu'au premier jeton (TTFT).
Pour les clients qui créent des assistants conversationnels et des applications agentiques, des historiques d'interaction plus longs peuvent augmenter la latence et consommer de la capacité des accélérateurs via des calculs de prefill répétés. Dans cet article, nous montrons comment le transfert de cache KV bi-directionnel permet aux nœuds de prefill et de decode de réutiliser le contexte précédemment calculé entre les tours, améliorant l'utilisation des accélérateurs et aidant les applications à maintenir un TTFT réactif à mesure que les conversations s'allongent.
Dans nos benchmarks multi-tours sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées avec AWS Elastic Fabric Adapter (AWS EFA, le réseau RDMA à faible latence utilisé entre les serveurs dans AWS), le transfert KV bi-directionnel a réduit le TTFT jusqu'à 1,6x pour Qwen3-32B et jusqu'à 3,3x pour zai-org/GLM-5-FP8 (voir la section Données de performance ); les résultats dépendent de la charge de travail et de la configuration.
Nous avons initialement développé et validé cette fonctionnalité sur des clusters d'instances AWS Trainium connectés avec EFA et l'avons contribué à vLLM comme capacité indépendante de l'accélérateur. Les résultats présentés ici proviennent d'un cluster de GPU Amazon EC2 P5en avec EFA, montrant que les bénéfices s'étendent également aux GPU. Cet article explique l'architecture de transfert bi-directionnel, le flux de métadonnées du routeur, les contrôles de rétention et de recalcul des blocs KV, les résultats de performance et comment reproduire le benchmark.
Transfert KV bi-directionnel
Le transfert KV bi-directionnel est un mécanisme qui permet à un nœud de decode de renvoyer des KV précédemment calculées à un nœud de prefill lors des tours suivants d'une conversation, évitant ainsi le recalcul du contexte partagé sur le nœud de prefill, contrôlé par un seuil de recalcul KV configurable. Cela atténue les deux scénarios de redondance computationnelle décrits précédemment, et sa réalisation exige que les KV survivent au tour qui les a produits et voyagent dans la direction inverse, coordonné par un routeur conscient du cache KV.
Améliorations du connecteur KV NIXL pour le transfert bi-directionnel
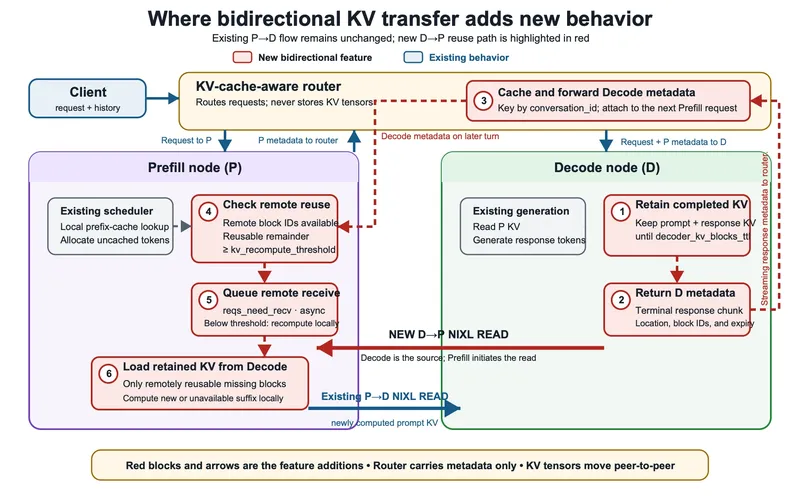
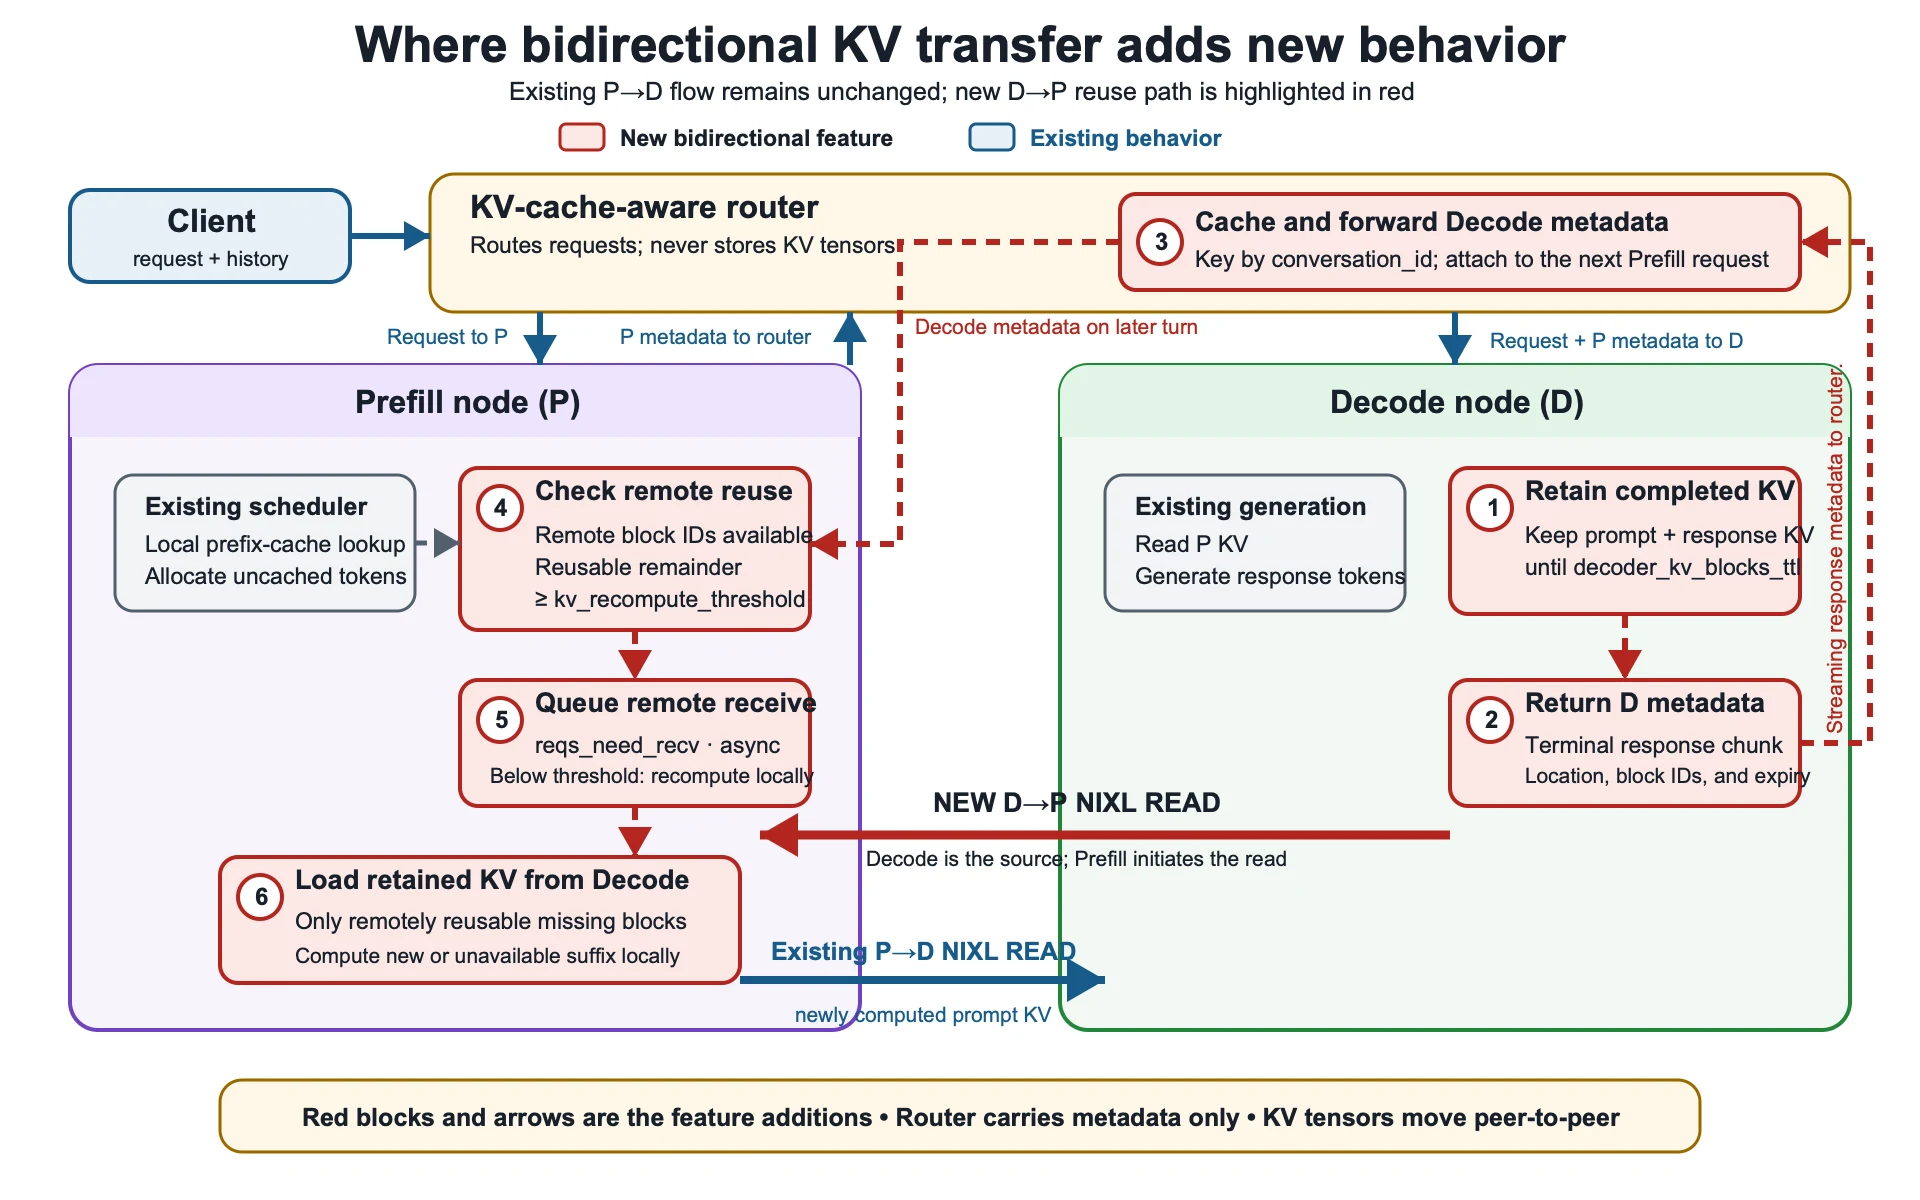
Nous avons étendu le NVIDIA Inference Xfer Library (NIXL) connecteur KV pour permettre aux nœuds de prefill de consommer des blocs KV distants, de la même manière que les nœuds de decode consomment déjà les blocs KV fournis par le nœud de prefill. Ce n'est pas un changement trivial, car les deux types de nœuds sont architecturalement différents : les nœuds de prefill calculent les représentations KV pour les nouveaux jetons d'invite et peuvent fournir des blocs KV d'invite complets. Les nœuds de decode n'ont pas la capacité (ou l'efficacité) de générer des représentations KV complètes et ne peuvent servir que des blocs KV précédemment mis en cache. Par conséquent, les nœuds de prefill et de decode conservent toujours leurs propres rôles et logiques pour calculer les métadonnées des blocs KV distants et locaux. Le mécanisme de transfert KV réel (un NIXL READ), cependant, est commun aux deux directions, la direction P->D et D->P la direction.
Le schéma suivant montre d'abord le flux existant en bleu : le routeur envoie la requête au nœud de prefill, le nœud de prefill calcule les KV de l'invite et renvoie leurs métadonnées de blocs, et le routeur transmet la requête et les métadonnées au nœud de decode pour le NIXL READ standard P→D. Le chemin rouge numéroté illustre les ajouts du transfert KV bi-directionnel : (1) le nœud de decode conserve les blocs KV éligibles après la génération, (2) renvoie leurs métadonnées dans la réponse en flux continu, et (3) le routeur met en cache ces métadonnées pour la prochaine requête de prefill. Le nœud de prefill ensuite (4) vérifie les KV réutilisables à distance après avoir appliqué les correspondances du cache local, (5) met en file d'attente une réception asynchrone lorsque le nombre de jetons réutilisables atteint le seuil, et (6) effectue un NIXL READ D→P avant de calculer le suffixe restant.
Routeur conscient du cache KV
vLLM inclut une prise en charge côté connecteur du transfert KV bidirectionnel, tandis que la coordination de la réutilisation du KV entre les tours de conversation nécessite un routeur conscient du cache KV. vLLM GitHub fournit un proxy d'exemple qui implémente le flux utilisé dans cet article et qui peut être adapté à votre environnement.
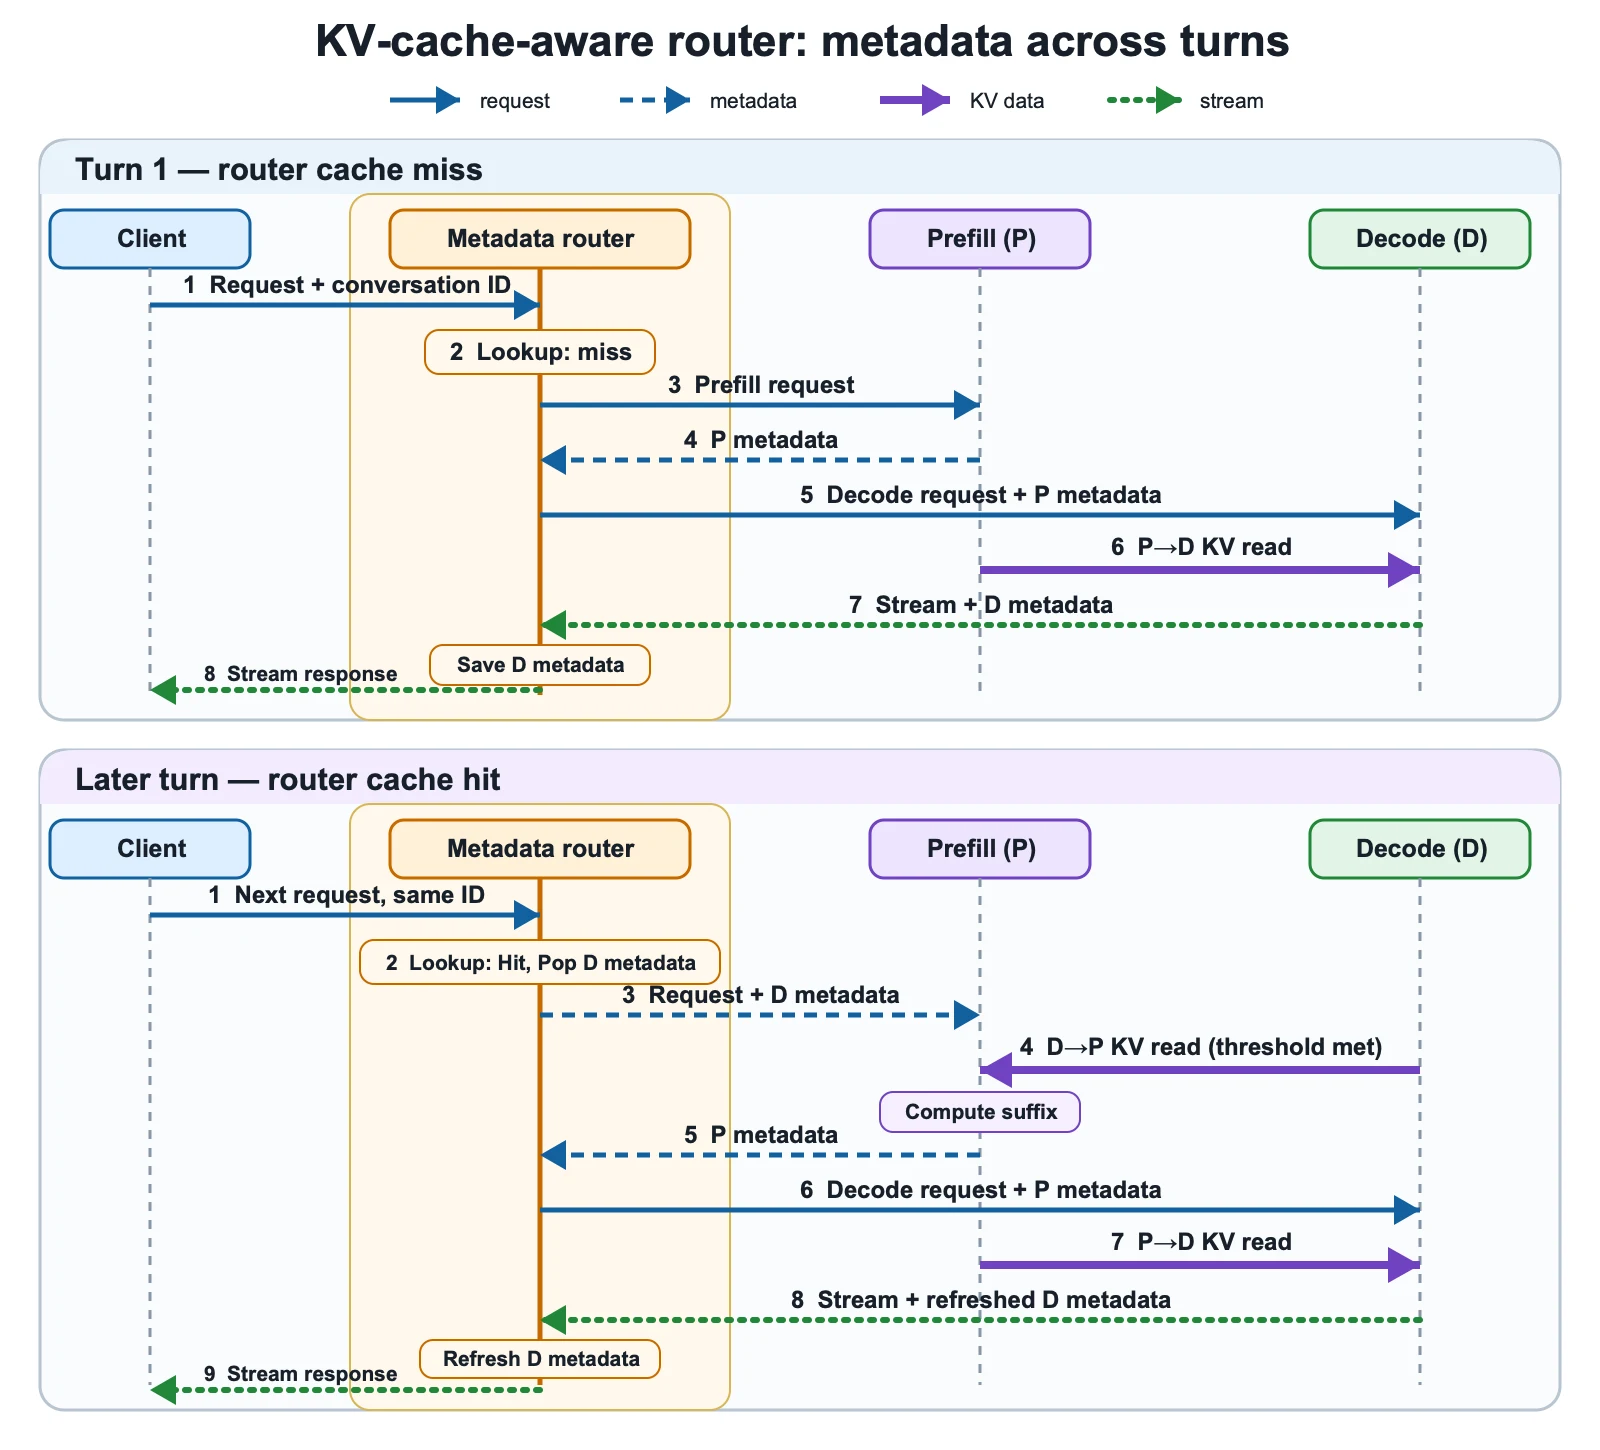
Le routeur conscient du cache KV est un composant de plan de contrôle léger et avec état, situé entre le client, les nœuds de prefill et de decode. Il maintient une correspondance en mémoire entre le conversation_id fourni par le client et le kv_transfer_paramsdu decode. Le routeur ne stocke que des métadonnées d'emplacement de blocs, pas de tenseurs KV, et obtient ces métadonnées à partir du flux de réponse plutôt qu'en interrogeant séparément le nœud de decode.
Le diagramme suivant montre comment le routeur gère les métadonnées KV entre les tours de conversation. Au premier tour, la recherche dans le cache échoue et la requête suit le flux P→D standard ; le routeur enregistre ensuite les métadonnées de decode à partir du flux de réponse. Aux tours suivants, le routeur récupère ces métadonnées à l'aide du conversation_id, ce qui permet au prefill de réutiliser le KV du decode, et actualise les métadonnées après la génération pour le tour suivant.
TTL de rétention des blocs
Normalement, une instance de decode libère les blocs d'une requête dès que la génération se termine. En mode bidirectionnel, elle les conserve pendant une durée de vie configurable (decoder_kv_blocks_ttl, par défaut 480 secondes) et publie leur emplacement et leur expiration, de sorte que le KV de la conversation, à la fois le préfixe du prompt et la réponse générée, reste disponible pour le tour suivant. Pour un tour qui arrive avant l'expiration du TTL, le nœud de prefill réutilise le KV ; un tour qui arrive plus tard revient au prefill normal. Comme ce TTL est fixe et non renouvelé, ajustez-le au délai attendu entre les tours afin d'équilibrer la réutilisation du KV et l'utilisation de la mémoire de l'accélérateur. Une amélioration naturelle suivante consisterait à étendre le bail renouvelé par battement de cœur au côté decode, afin qu'une instance de decode récupère les blocs dès qu'une conversation devient inactive plutôt qu'à la fin d'un minuteur fixe.
Seuil de recalcul KV
La réutilisation du KV n'est pas toujours plus rapide que le recalcul local. Pour un préfixe réutilisable court, la surcharge d'interconnexion et de coordination peut dépasser le temps nécessaire au recalcul des tokens. Le paramètre kv_recompute_threshold , dont la valeur par défaut est 64 tokens, contrôle cette décision. Le nœud de prefill recalcule lorsque le nombre de tokens à calculer est inférieur au seuil et récupère le KV depuis le nœud de decode lorsqu'il est égal ou supérieur au seuil. Les déploiements peuvent ajuster cette valeur en fonction du temps de calcul du modèle, de la taille du KV et des performances de l'interconnexion.
Données de performance
Pour l'évaluation, nous avons utilisé les modèles Qwen3-32B et GLM-5-FP8 sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées via EFA. Pour émuler les scénarios dans lesquels le nœud de prefill a expulsé son cache local ou le routeur sélectionne un nœud de prefill différent qui ne possède pas les blocs KV de la conversation, nous avons désactivé le cache de préfixe sur le nœud de prefill avec --no-enable-prefix-caching.
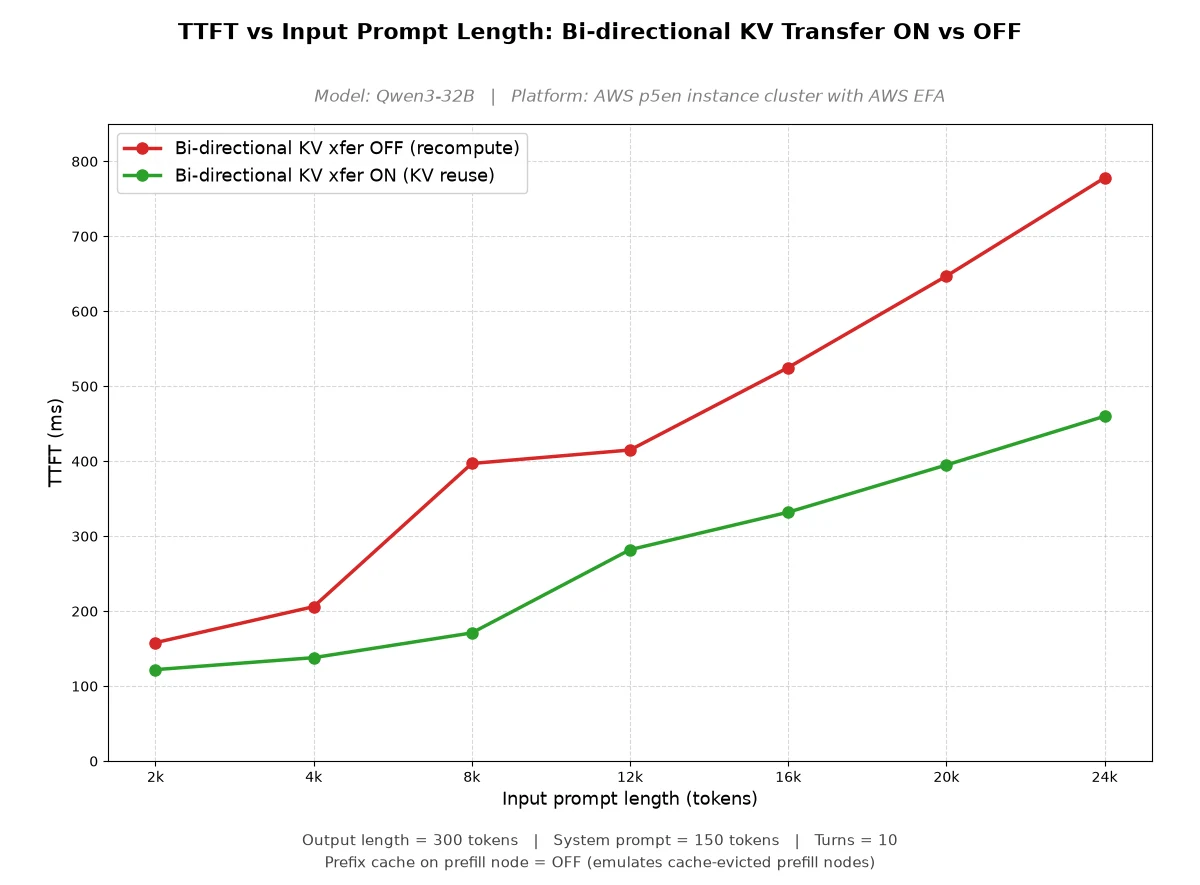
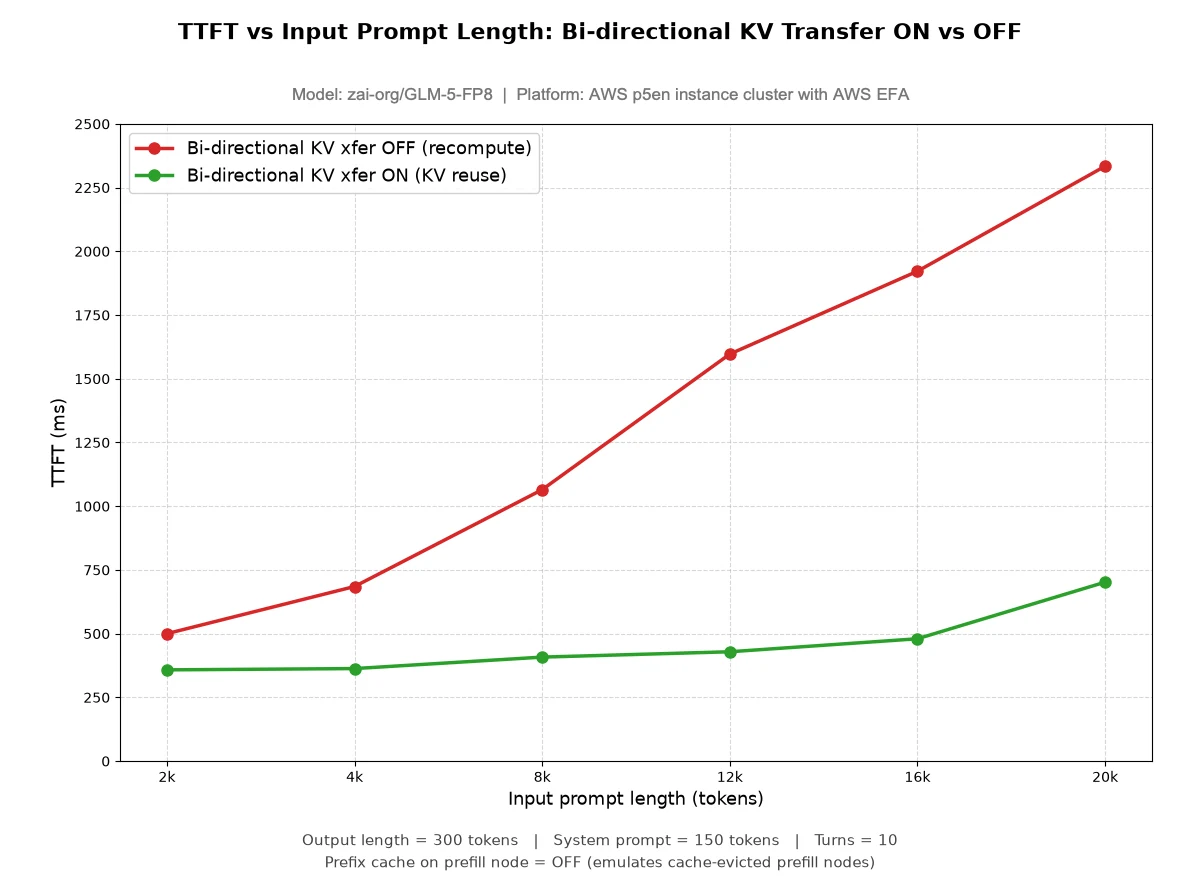
Pour les deux modèles, l'activation du transfert KV bidirectionnel réduit le calcul de prefill sur les conversations à plusieurs tours, et le bénéfice augmente généralement avec la longueur du prompt. Avec la fonctionnalité désactivée, l'instance de prefill recalcule l'intégralité du contexte accru à chaque tour, de sorte que le TTFT grimpe fortement : Qwen3-32B passe de 158 ms à 2k à 778 ms à 24k, et GLM-5-FP8 de 500 ms à 2k à 2,334 ms à 20k. Avec la fonctionnalité activée, le KV conservé de l'instance de decode est réutilisé au lieu d'être recalculé, maintenant le TTFT beaucoup plus stable : Qwen3-32B ne passe que de 122 ms à 460 ms sur la même plage (soit environ une réduction d'un facteur 1.6x au prompt le plus long), tandis que GLM-5-FP8 passe de 358 ms à 702 ms et reste jusqu'à 3.3x en dessous du chemin de recalcul sur les longs prompts. La répartition de la durée de prefill explique pourquoi.
Le transfert bi-directionnel ajoute un temps de transfert KV faible (environ 30 ms à 130 ms pour Qwen3-32B ; environ 29 ms à 110 ms pour GLM-5-FP8), mais le calcul de préfill qu'il supprime l'emporte de loin sur ce temps de transfert KV. Ainsi, la durée totale de préfill avec le transfert activé (Qwen3-32B : 128 ms à 414 ms ; GLM-5-FP8 : 316 ms à 541 ms) reste bien en dessous du chemin en recompute uniquement (Qwen3-32B : 153 ms à 744 ms ; GLM-5-FP8 : 500 ms à 2,331 ms). Le modèle plus grand GLM-5-FP8 présente un écart plus important en valeur absolue et relative, car son temps de recompute par token plus élevé rend la réutilisation du KV d'autant plus rentable à mesure que les modèles et les contextes grandissent.
Qwen3-32B
Le graphique ci-dessous trace le TTFT en fonction de la longueur du prompt pour Qwen3-32B, en comparant le transfert KV bi-directionnel activé et désactivé.
Le graphique suivant décompose la durée de préfill des mêmes exécutions en ses composantes de recompute et de transfert KV.
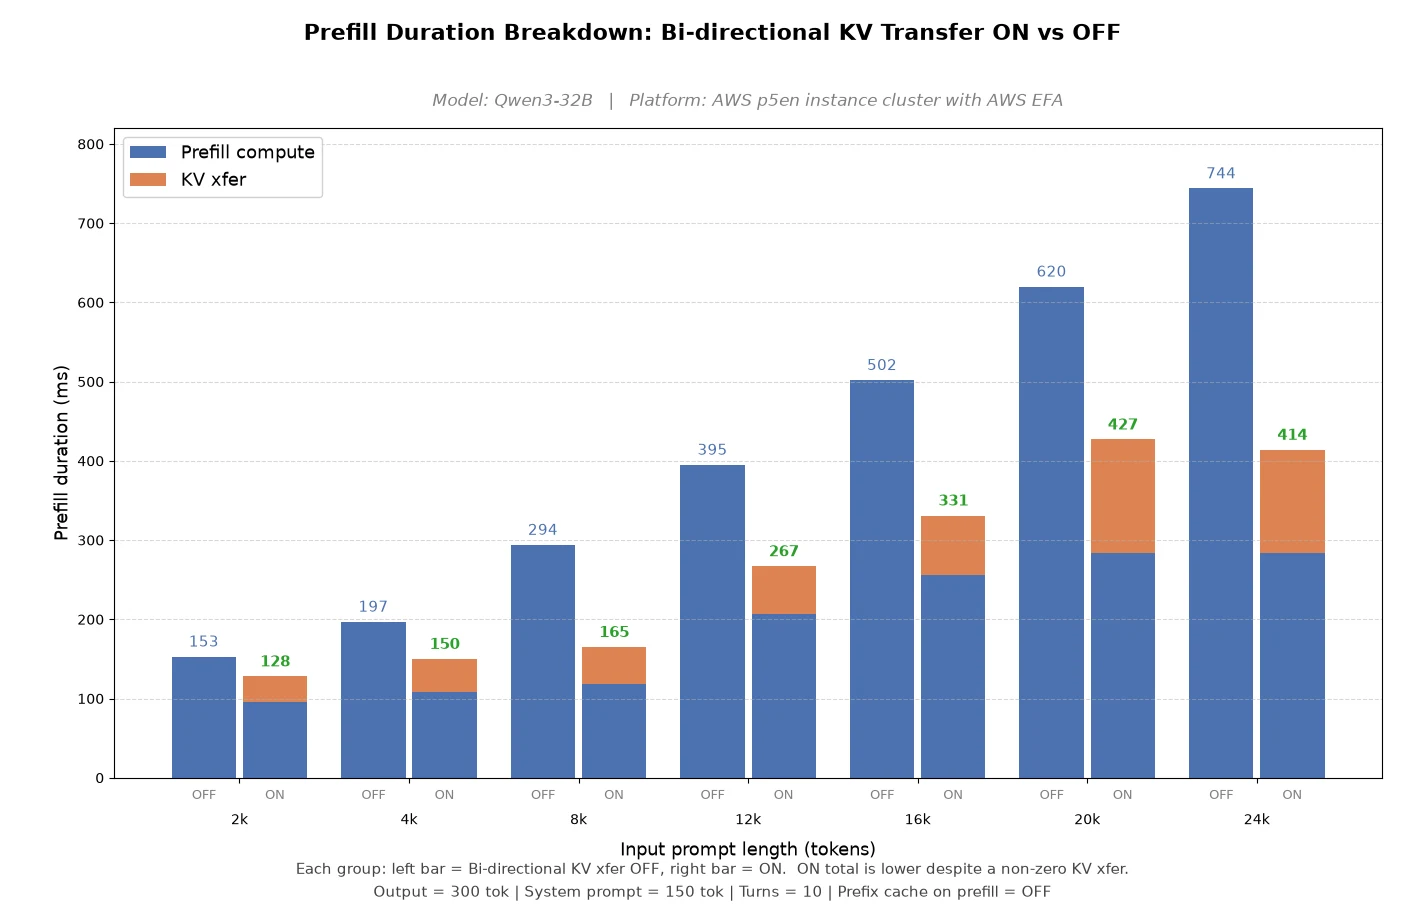
Ensemble, ces graphiques montrent que le TTFT reste quasiment plat avec la fonctionnalité activée, tandis que le chemin désactivé grimpe fortement à mesure que le contexte grandit, car le faible temps de transfert KV est largement compensé par le recompute qu'il supprime.
zai-org/GLM-5-FP8
Les mêmes deux vues suivent pour GLM-5-FP8. La première trace le TTFT en fonction de la longueur du prompt avec la fonctionnalité activée et désactivée.
La seconde décompose la durée de préfill en ses composantes de recompute et de transfert KV.
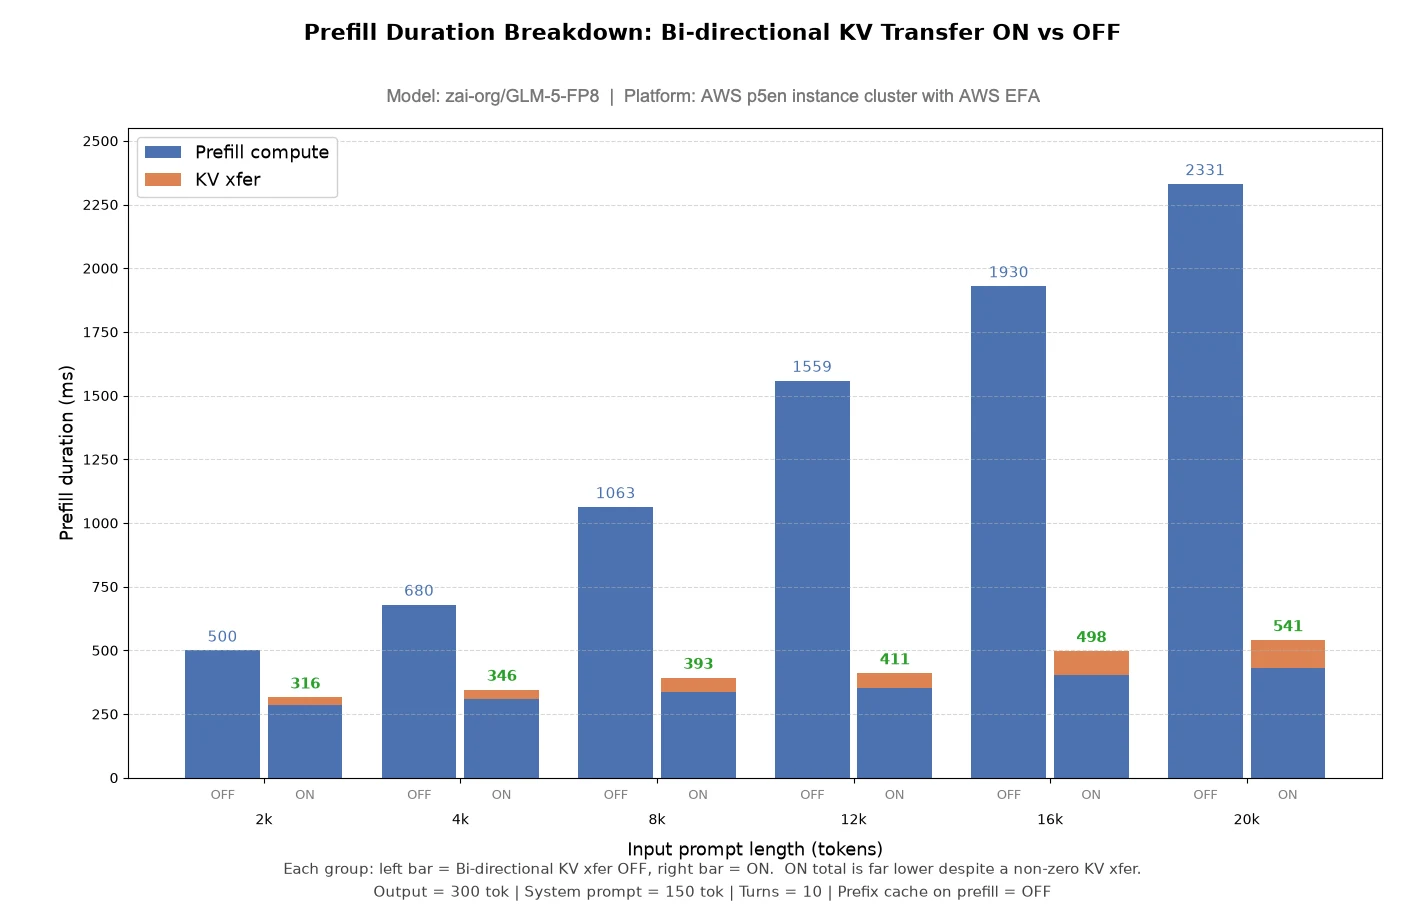
GLM-5-FP8 montre un écart bien plus important que Qwen3-32B, jusqu'à environ 3.3x de TTFT inférieur pour les longs prompts, car son temps de recompute par token plus élevé rend la réutilisation du KV d'autant plus rentable à mesure que la longueur du contexte grandit.
Comment exécuter le benchmark
Pour reproduire notre configuration de benchmark 1P1D, un nœud de prefill et un nœud de décode, en utilisant des instances Amazon EC2 P5en avec EFA, suivez les instructions pas à pas du Reproducing our results guide ci-dessous. Ce guide couvre la configuration de l'environnement, le lancement des serveurs de prefill et de décode vLLM, l'exécution du benchmark et la collecte des résultats. La fonctionnalité peut fonctionner sur d'autres configurations prises en charge, mais les résultats de performance varieront selon le matériel, le modèle, la charge de travail et la configuration réseau.
Conclusion
Dans cet article, nous avons montré comment le transfert bi-directionnel de cache KV peut réduire le TTFT à mesure que l'historique de conversation d'un agent grandit. Dans les déploiements désagrégés P-D, la fonctionnalité permet au nœud de prefill de réutiliser les blocs KV conservés par le nœud de décode d'un tour à l'autre, réduisant les calculs répétés. Des seuils configurables de rétention de blocs et de recompute déterminent le moment où la réutilisation a lieu. Sur un déploiement 1P1D utilisant des instances Amazon EC2 P5en connectées avec EFA, aux plus longues longueurs de prompt testées, nous avons observé des réductions de TTFT de 1.6x pour Qwen3-32B et de 3.3x pour zai-org/GLM-5-FP8 ; les résultats dépendent de la charge de travail et de la configuration de déploiement. Pour implémenter cela dans votre environnement, utilisez vLLM v0.21.0 ou une version ultérieure avec NixlConnector, activez bidirectional_kv_xfer sur les serveurs de prefill et de décode, utilisez un routeur tenant compte du cache KV, et suivez le reproduction guide.
Ressources connexes
- AWS EFA
- Prefill-Decode (P-D) disaggregated serving
- Benchmark KV Cache Offloading with Multi-Turn Conversations
Remerciements
Nous remercions Nicolò Lucchesi (Mistral), Mark McLoughlin (Red Hat) et la communauté vLLM pour leur soutien dans la maintenance de cette fonctionnalité.
Annexe : Reproducing our results
La topologie est composée de deux instances AWS p5en (prefill sur :8100, décode sur :8200) avec EFA activé, plus un troisième petit nœud exécutant le proxy et le client de benchmark sur :8000.
Trois scripts sont livrés avec cet article : serve_pd_multiturn.sh lance l'un ou l'autre des groupes avec la fonctionnalité activée ou désactivée, run_multiturn_sweep.sh pilote le balayage de la longueur du prompt, et cleanup.sh démonte le déploiement.
Environnement de test
Les deux nœuds GPU étaient configurés de manière identique :
| Type d'instance | p5en.48xlarge (8x NVIDIA H200), un pour le prefill et un pour le decode |
| Région / AZ | ap-south-1 (Mumbai), ap-south-1b (ID de AZ aps1-az3), les deux nœuds dans la même AZ |
| Placement | Pas de groupe de placement de cluster ; les deux instances lancées dans une réservation de capacité à la demande ciblée (On-Demand Capacity Reservation), locataire par défaut |
| AMI | Image publique AWS ParallelCluster 3.14.2 pour Ubuntu 24.04 x86_64, aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae en ap-south-1; les AMI IDs diffèrent selon la région). Il est livré avec le kernel 6.14.0-1018-aws, le pilote NVIDIA 570 et CUDA 12.8, donc mettez à jour le pilote, le CUDA toolkit et l'installateur EFA vers les versions ci-dessous. |
| OS / kernel | Ubuntu 24.04.4 LTS, 6.14.0-1018-aws |
| Pilote NVIDIA / CUDA | Pilote 580.126.16 (pilote API CUDA 13.0) ; CUDA toolkit 13.0 |
| Interfaces EFA | 16 par instance, une par carte réseau (cartes 0-15, tous de type d'interface efa), 200 Gb/s chacune pour un total de 3.2 Tb/s. 8 interfaces se trouvent sur chaque nœud NUMA, et chaque GPU partage un switch PCIe avec 2 d'entre elles. |
| Logiciel EFA | Installateur EFA 1.50.0, module kernel EFA 3.3.0g, libfabric 2.6.0amzn1.0, rdma-core 64.0amzn0 |
Sélection des périphériques EFA par NIXL. Le backend LIBFABRIC ouvre les 16 périphériques EFA en tant que rails avec le provider efa . Il enregistre ensuite le KV cache de chaque GPU uniquement sur les 2 rails qui partagent le switch PCIe de ce GPU, de sorte que chaque transfert reste local au PCIe. Aucun override de périphérique NIXL ou libfabric n'était défini ; il s'agit de la sélection par défaut. Pour le confirmer sur vos propres nœuds, lancez les serveurs avec NIXL_LOG_LEVEL=DEBUG et vérifiez les lignes d'enregistrement :
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. Provisionner les nœuds
Installez la pile userspace EFA sur les deux nœuds GPU et confirmez que le provider est présent. Nous avons utilisé l'installateur 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa -t FI_EP_RDM            # verify the EFA provider is present on both GPU nodes
2. Installer vLLM et NIXL sur les deux nœuds GPU
python3 -m venv ~/venv-pd && source ~/venv-pd/bin/activate
pip install --upgrade pip && pip install vllm==0.29.0 nixl==1.4.1
Appliquez la PR vLLM #40186 une fois sur les deux nœuds. Elle attache kv_transfer_params au streaming des réponses, ce dont le proxy multi-tours a besoin pour lier les tours : le proxy interroge toujours le nœud de décodage avec stream=True, donc sans ce correctif le nœud de décodage ne renvoie jamais les métadonnées du bloc et chaque tour arrive comme un échec de cache.
SITE=$(python -c 'import site; print(site.getsitepackages()[0])')
curl -sL https://github.com/vllm-project/vllm/pull/40186.diff -o /tmp/40186.diff
patch -p1 -d "$SITE" --fuzz=3 < /tmp/40186.diff
3. Télécharger le modèle
export HF_HOME=/fsx/huggingface        # a large shared volume
hf download Qwen/Qwen3-32B
4. Lancer la paire P/D
Run serve_pd_multiturn.sh une fois par nœud GPU. BIDIR est la seule chose qui change entre les deux branches de l'A/B, et elle doit correspondre sur les deux nœuds :
# on the prefill node
P_IP=<P_IP> D_IP=<D_IP> ROLE=prefill BIDIR=false ./serve_pd_multiturn.sh
# on the decode node
P_IP=<P_IP> D_IP=<D_IP> ROLE=decode  BIDIR=false ./serve_pd_multiturn.sh
Ce qui se développe en, côté préremplissage :
export FI_PROVIDER=efa
export VLLM_NIXL_SIDE_CHANNEL_HOST=<P_IP> VLLM_NIXL_SIDE_CHANNEL_PORT=5600
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 \
  --no-enable-prefix-caching --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"],
    "kv_recompute_threshold":64,"decoder_kv_blocks_ttl":480,
    "bidirectional_kv_xfer":false}}'
--no-enable-prefix-caching est défini uniquement sur le nœud de préremplissage — c'est le scénario d'éviction du cache que le benchmark émule. Laissez le cache de préfixes activé sur le nœud de décodage. Attendez que les deux /health points de terminaison renvoient 200.
5. Démarrer le proxy multi-tours
python3 -m venv ~/venv-proxy && source ~/venv-proxy/bin/activate
pip install fastapi uvicorn httpx pandas numpy aiohttp transformers tqdm
sudo dnf install -y jq || sudo apt-get install -y jq
git clone --depth 1 --branch v0.29.0 https://github.com/vllm-project/vllm.git ~/vllm_src
export VLLM_SRC=~/vllm_src

python3 $VLLM_SRC/examples/disaggregated/disaggregated_serving/disagg_proxy_multiturn.py \
  --port 8000 --prefiller-host <P_IP> --prefiller-ports 8100 \
  --decoder-hosts <D_IP> --decoder-ports 8200 \
  2>&1 | tee ~/proxy_$(date +%Y%m%d_%H%M%S).log
Le proxy prend des hôtes et des ports, pas des URL. La réutilisation est pilotée par le client qui envoie conversation_id, il n'y a donc aucun drapeau à activer ici.
6. Exécuter la branche OFF, puis la branche ON
VLLM_SRC=~/vllm_src LEG=off ./run_multiturn_sweep.shPour la branche ON, arrêtez les deux serveurs et le proxy, relancez l'étape 4 avec BIDIR=true sur chaque nœud, redémarrez le proxy (son cache de conversation est en mémoire du processus), puis :
VLLM_SRC=~/vllm_src LEG=on ./run_multiturn_sweep.shRépétez les deux branches pour GLM-5-FP8 avec MODEL=zai-org/GLM-5-FP8 SERVED_NAME=GLM.
7. Collecter les chiffres
Trois quantités, une par source :
- TTFT, à partir des statistiques JSON par requête du benchmark écrites par
--stats-json-output. Chaque enregistrement contientttft_msà côté deinput_num_tokensetconversation_id. C'est l'axe des ordonnées des graphiques TTFT. - Durée de préremplissage, à partir du journal du proxy, qui rapporte la partie préremplissage de chaque requête sous la forme
Prefill done in <N>ms. C'est la hauteur totale de chaque barre dans la ventilation des durées de préremplissage. - Temps et volume de transfert KV, à partir du journal du nœud de préremplissage, qui rapporte des lignes
KV Transfer metrics:avec le temps de transfert moyen et P90, les octets par transfert et le débit. C'est le composant KV-xfer de chaque barre ON.
La télémétrie NIXL est enregistrée par le côté qui initie le transfert, donc la relecture D->P apparaît dans le journal du nœud de prefill tandis que le tirage ordinaire P->D apparaît dans le journal du nœud de decode.
Calculez la moyenne de chaque quantité par longueur de prompt, puis tracez : le TTFT en fonction de la longueur du prompt sous forme de deux lignes (ON et OFF), et la durée de prefill sous forme de barres empilées appariées par longueur de prompt, la barre ON étant scindée entre calcul de prefill et transfert KV. La différence entre les deux vues est l'essentiel — le coût de transfert que les barres révèlent est ce que les lignes de TTFT convertissent en économie.
Dépannage
- Le proxy journalise toujours
cache MISSdans une exécution ON — absence de--send-conversation-id, la PR #40186 n'est pas appliquée sur les deux nœuds, ouBIDIR=falselaissé sur le nœud de decode, auquel cas il ne renvoie aucunkv_transfer_paramsdu tout. Declining expired remote readsur le nœud de prefill — les blocs du nœud de decode ont expiré avant l'arrivée du tour suivant. Augmentezdecoder_kv_blocks_ttl(par défaut 480 s) et maintenez le TTL du cache du proxy en dessous.fi_info -p efaest vide ou revient aux sockets — le fournisseur EFA est absent. Réinstallezaws-efa-installeret confirmez que les instances ont été lancées avec des interfaces compatibles EFA ; sans cela, NIXL soit échoue à s'initialiser, soit s'exécute silencieusement en TCP, ce qui rend les chiffres de transfert dénués de sens.
Nettoyage
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
Puis résiliez les instances et vérifiez qu'aucune ne reste en cours d'exécution.