
Muse Wonder et Muse Wonder Full : un bond material en intelligence par rapport aux précédents modèles de Meta
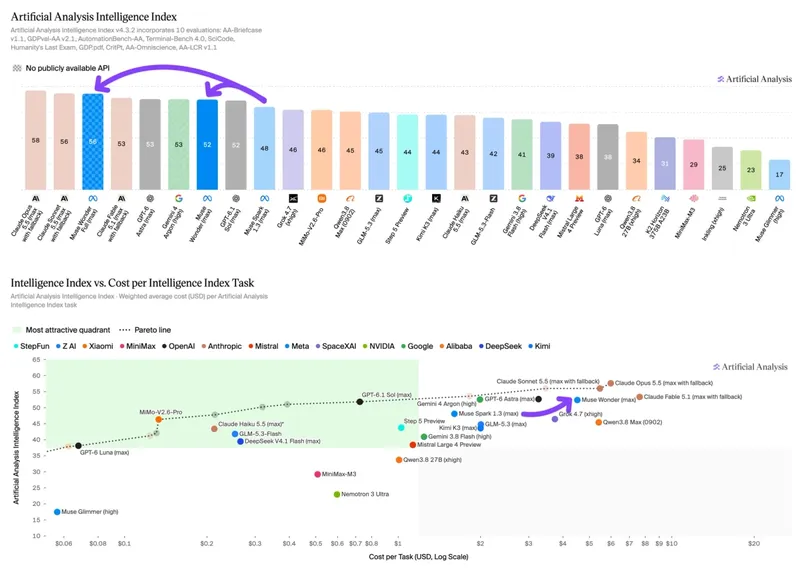
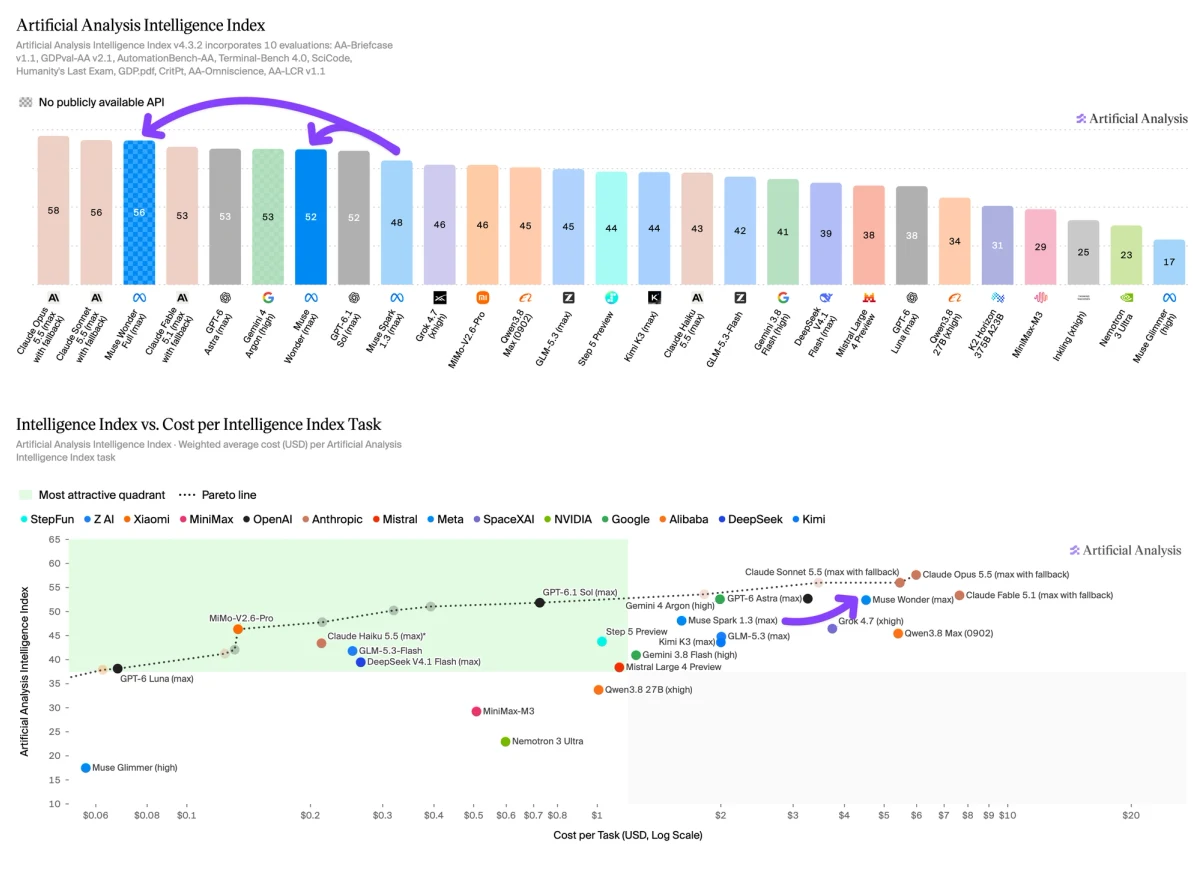
Voir la page du modèleMeta a publié Muse Wonder et Muse Wonder Full, obtenant des scores de 52 et 56 à l'Artificial Analysis Intelligence Index v4.3 au niveau de raisonnement maximal - chacun un gain material par rapport à Muse Spark 1.3 (max) à 48, avec un intervalle de seulement 6 semaines entre les deux sorties
Muse Wonder est disponible pour les utilisateurs de l'API first-party de Meta, tandis que Muse Wonder Full n'est actuellement disponible que pour les utilisateurs de Muse Code. Meta précise que chaque modèle est conçu pour un usage agent personnel et professionnel
Points clés :
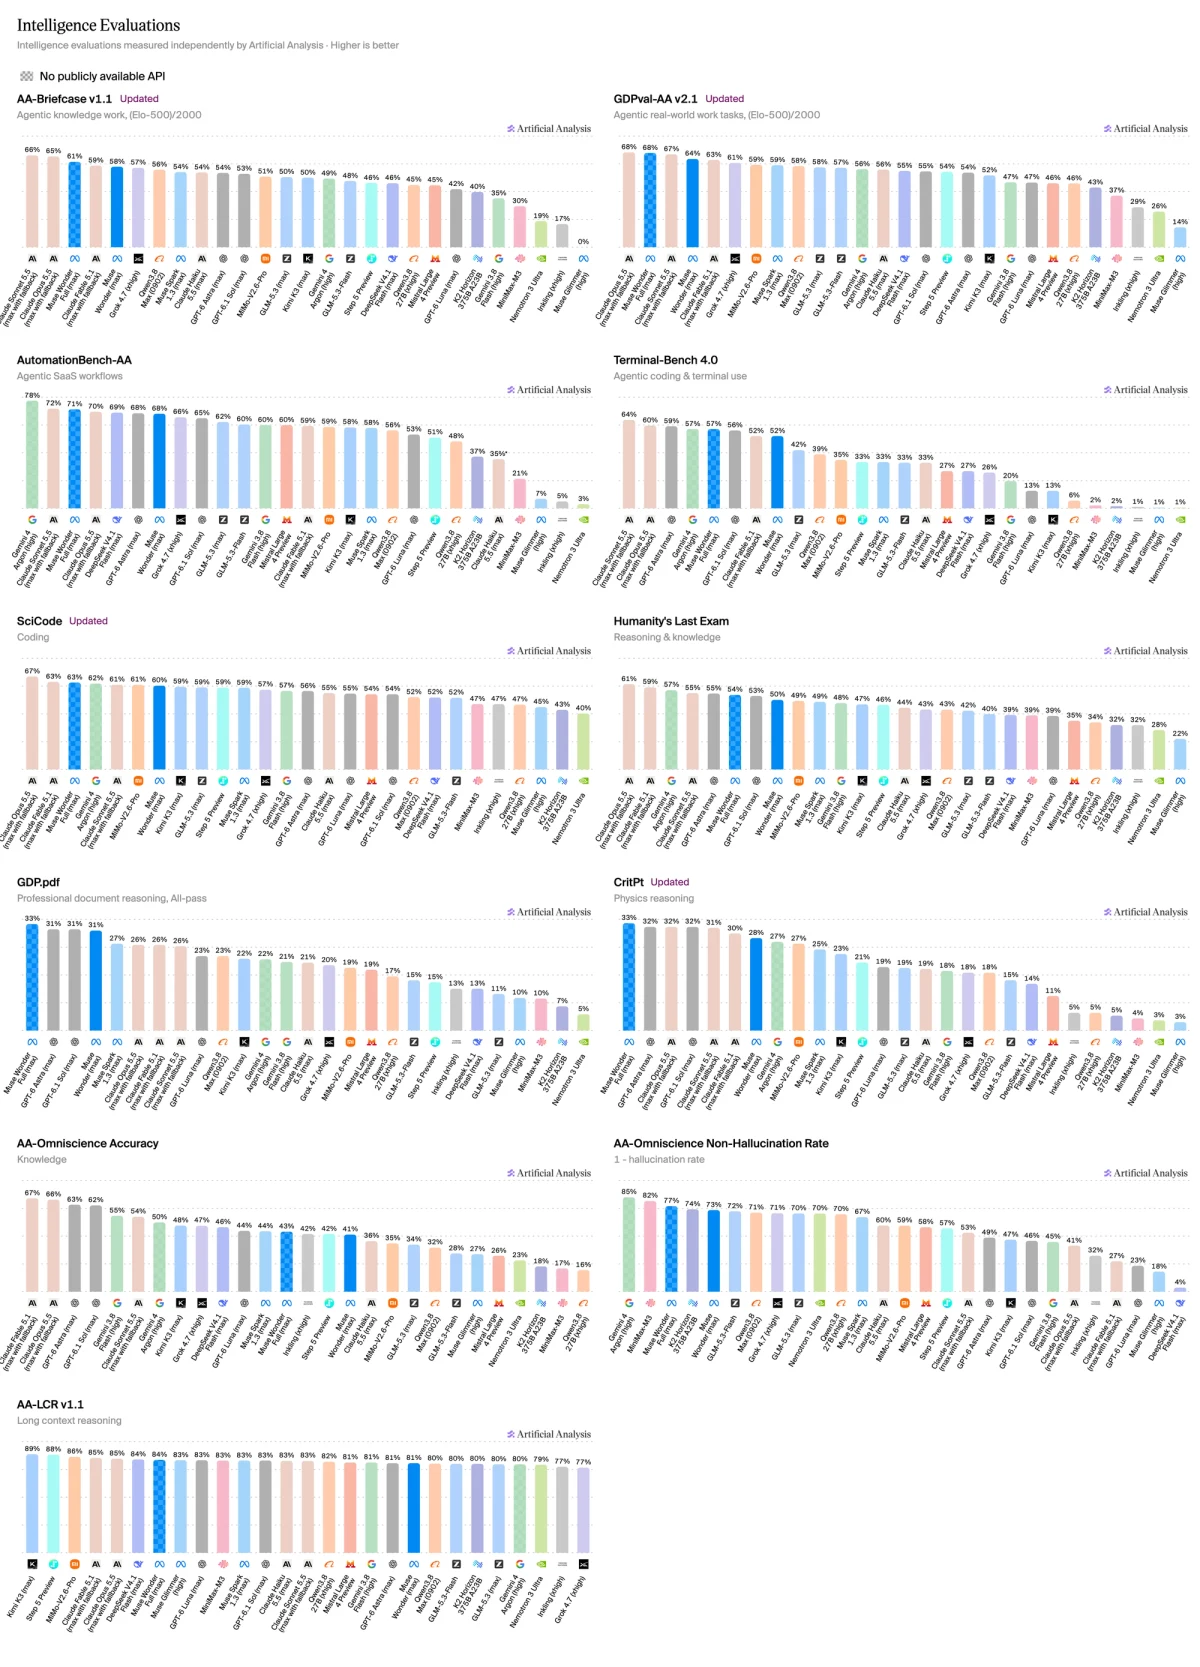
➤ Les deux modèles affichent un bond material dans le score global de l'Intelligence Index. Muse Wonder Full (max) améliore Muse Spark 1.3 (max) sur les dix évaluations de l'Intelligence Index, gagnant 8 points pour atteindre 56. Les plus grands gains ont été observés dans les évaluations agentiques : Terminal-Bench 4.0 (+24 points, 33% à 57%), GDPval-AA v2.1 (+176 Elo, 1681 à 1857) et AA-Briefcase (+148 Elo, 1581 à 1729). Muse Wonder (max) gagne 4 points d'Intelligence Index et s'établit à 52, avec des améliorations notables face à Muse Spark 1.3 (max) sur Terminal-Bench 4.0 (33% à 52%) et AutomationBench-AA (58% à 68%)
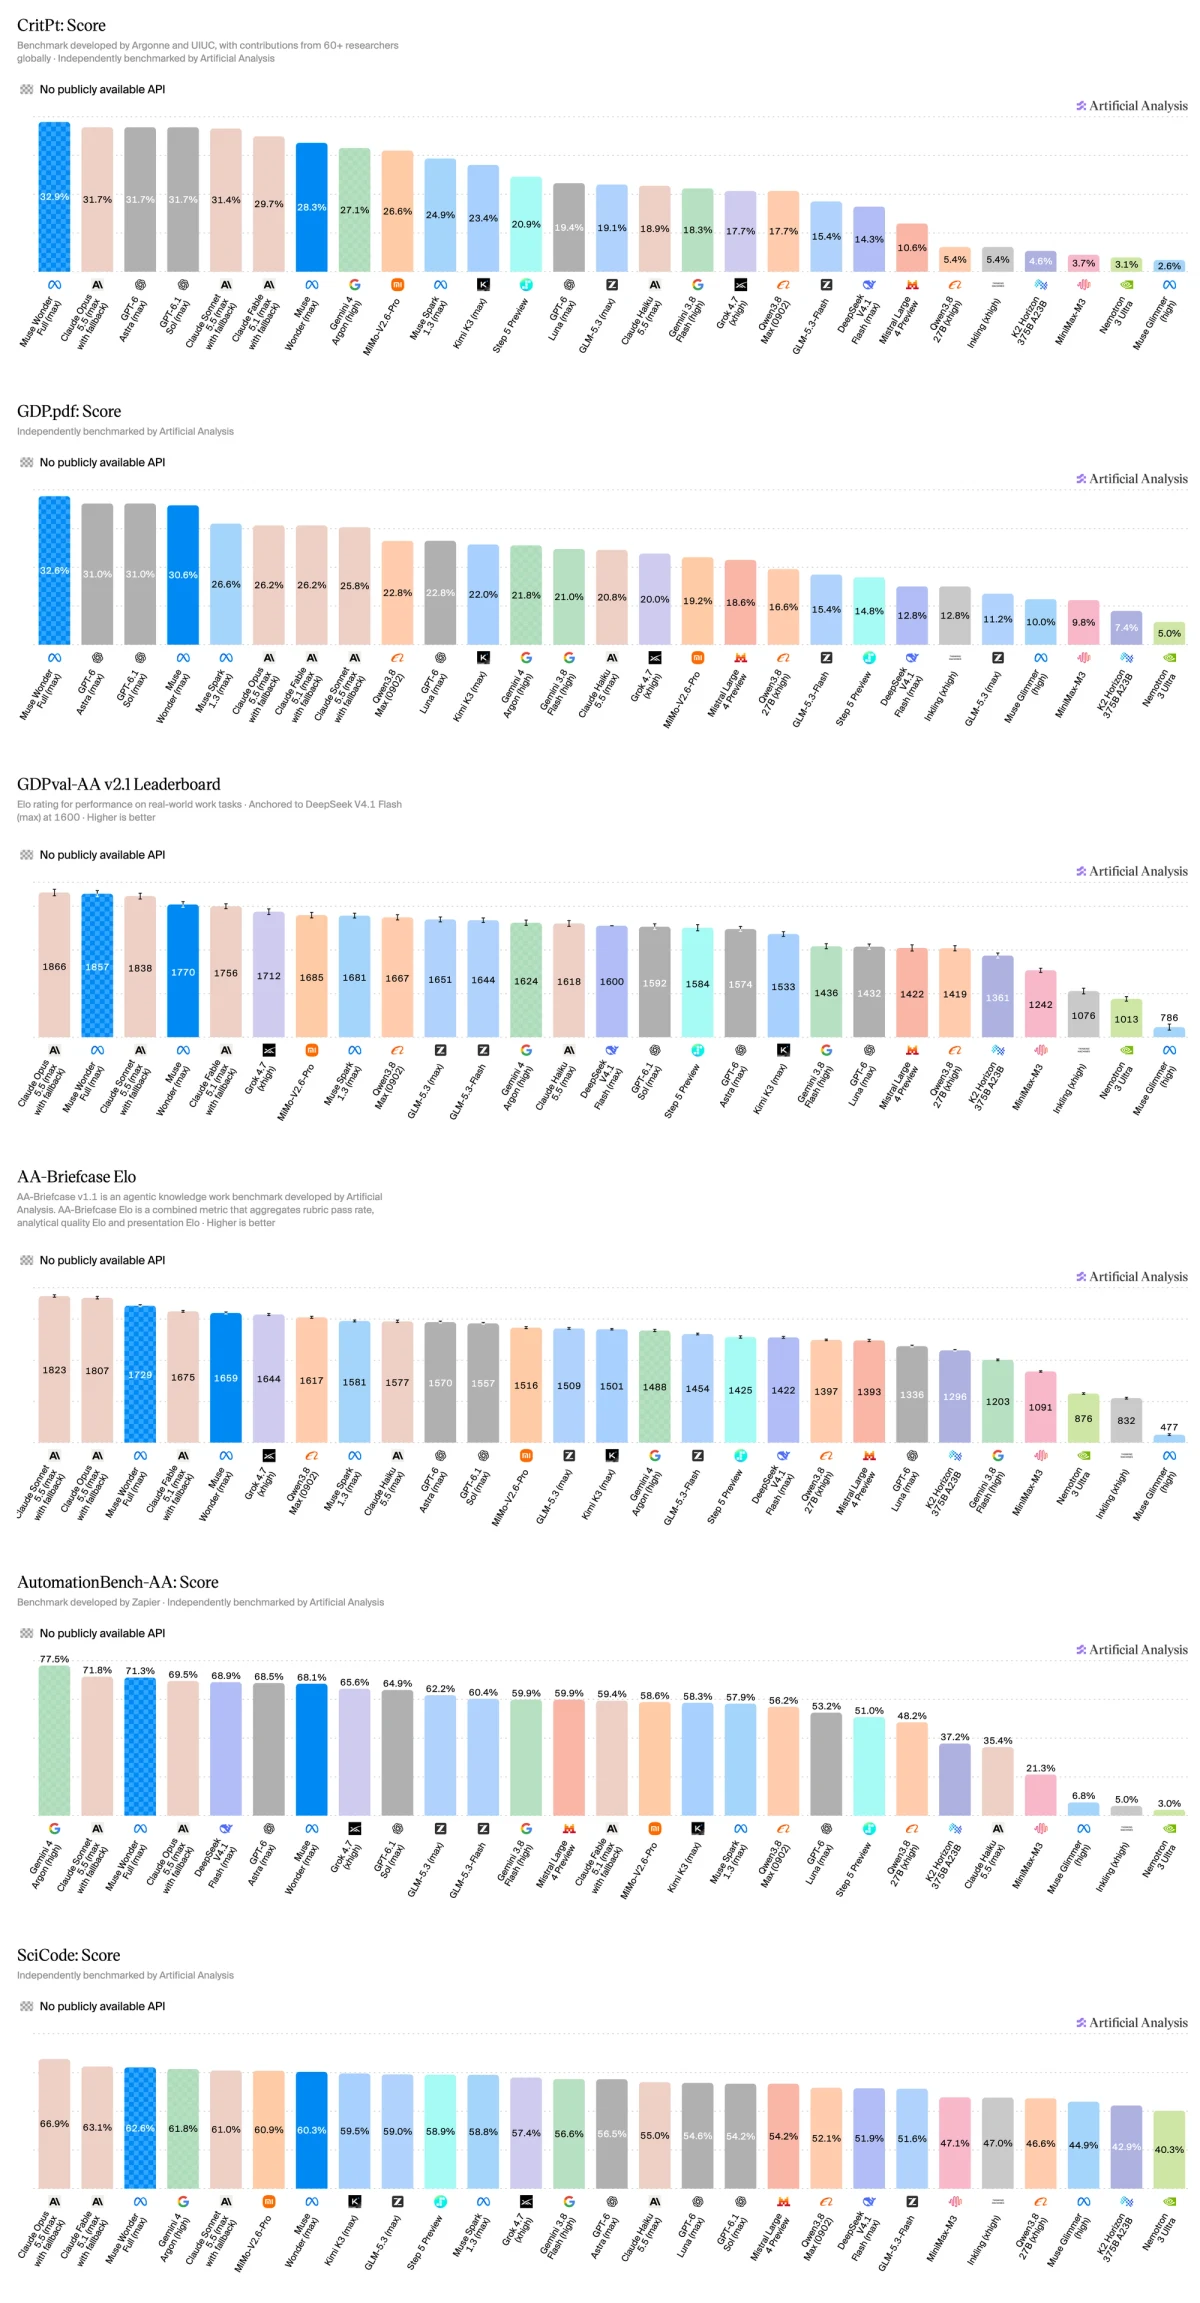
➤ Muse Wonder Full (max) se place dans le top trois sur six des dix évaluations de l'Intelligence Index, et est particulièrement performant dans le travail de connaissances agentique et le raisonnement scientifique. Dans le travail de connaissances agentique, il mène de justesse sur GDP.pdf (33%), se classe #2 sur GDPval-AA v2.1 (1857 Elo), et #3 à la fois sur AA-Briefcase (1729 Elo) et AutomationBench-AA (71%). En raisonnement scientifique, il domine le classement CritPt à 33% et se classe #3 sur SciCode avec 63%. Cela s'appuie sur les forces relatives de Muse Spark 1.3 (max), qui montrait aussi une capacité particulière dans ces deux domaines
➤ Les deux modèles utilisent moins de tokens de sortie que Muse Spark 1.3 (max). Muse Wonder (max) et Muse Wonder Full (max) utilisent chacun environ 54k tokens de sortie par tâche de l'Intelligence Index, en baisse d'environ 10% par rapport à Muse Spark 1.3 (max, 60k). Cet usage est inférieur à celui de modèles d'intelligence similaire, Gemini 4 Argon (high, 62k) et Claude Fable 5.1 (max w/ fallback, 78k), mais supérieur à GPT-6.1 Sol (max, 38k) et GPT-6 Astra (max, 27k). Muse Wonder Full (max) utilise 16% de tokens d'entrée en moins par tâche de l'Intelligence Index que Muse Wonder (max) (6.44M contre 7.69M), ce qui signifie qu'il est à la fois plus intelligent et plus économe en tokens
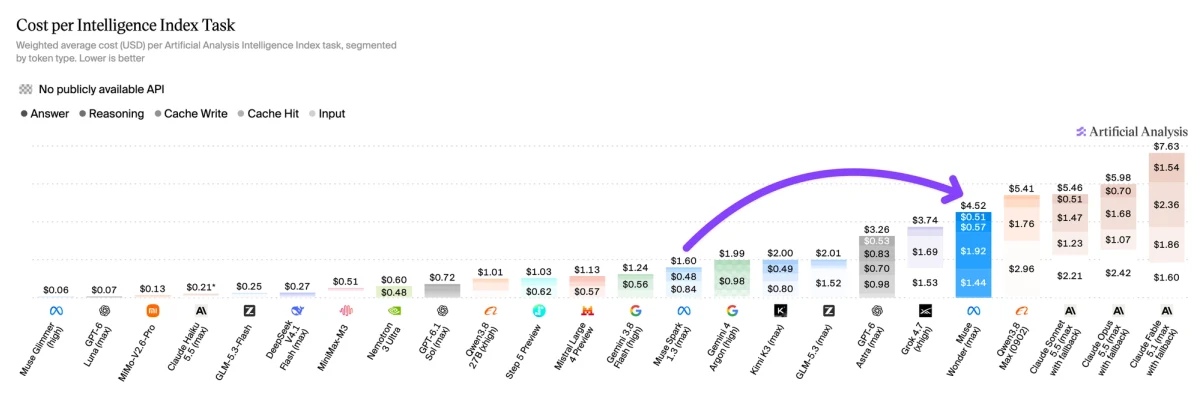
➤ Le coût par tâche de Muse Wonder (max) est plus élevé que celui de la plupart des modèles d'intelligence similaire. Malgré une utilisation efficace des tokens de sortie, la tarification API premium (4 $ par million de tokens d'entrée, 20 $ par million de tokens de sortie) et un usage élevé de tokens d'entrée (7.69M par tâche) portent le coût de Muse Wonder (max) à 4,52 $ par tâche de l'Intelligence Index. C'est moins que Claude Fable 5.1 (max w/ fallback, 7,63 $), Claude Opus 5.5 (max w/ fallback, 5,98 $) et Claude Sonnet 5.5 (max w/ fallback, 5,46 $), mais plus que GPT-6 Astra (max, 3,26 $), Gemini 4 Argon (high, 1,99 $), GPT-6.1 Sol (max, 0,72 $) et son prédécesseur Muse Spark 1.3 (max, 1,60 $). Muse Wonder Full n'est pas tarifé par token, donc aucun chiffre de coût par tâche n'est disponible
➤ Les deux modèles gagnent significativement en performance d'agent de codage. Muse Wonder Full atteint 68 sur l'Artificial Analysis Coding Agents Index au niveau maximal dans Muse Code, aux côtés de Claude Code avec Sonnet 5.5 (max, 68) et Opus 5.5 (max, 66). Muse Wonder (max) obtient 63. Cela représente des gains materials par rapport à Muse Code avec Muse Spark 1.3 (max), qui obtient 54
Autres détails pour les deux nouveaux modèles :
➤ Fenêtres de contexte : 1M tokens chacun, inchangé par rapport à Muse Spark 1.3
➤ Tarification : pour Muse Wonder, 4 $ d'entrée / 0,20 $ d'entrée en cache / 20 $ de sortie par 1M tokens. Muse Wonder Full n'est pas tarifé par token
➤ Modalités d'entrée : texte, image, vidéo et audio
➤ Modalités de sortie : texte
➤ Disponibilité : Muse Wonder est disponible sur l'API first-party de Meta et sur Muse Code au lancement, tandis que Muse Wonder Full n'est disponible que pour les utilisateurs de Muse Code
Muse Wonder Full (max) se place dans le top trois sur six des dix évaluations de l'Artificial Analysis Intelligence Index v4.3 :
➤ #1 sur CritPt (33%) et GDP.pdf (33%)
➤ #2 sur GDPval-AA v2.1 (1857 Elo)
➤ #3 sur AA-Briefcase (1729 Elo), AutomationBench-AA (71%) et SciCode (63%)
Les avances sur CritPt et GDP.pdf sont étroites, les concurrents les plus proches obtenant 31-32%. Sur GDPval-AA v2.1, son résultat se situe dans les intervalles de confiance de Claude Opus 5.5 (max w/ fallback, 1866) et de Claude Sonnet 5.5 (max w/ fallback, 1838)
Sa plus grande amélioration par rapport à Muse Spark 1.3 (max) porte sur Terminal-Bench 4.0 : de 33% à 57%, le plaçant au niveau de Gemini 4 Argon (high)
Muse Wonder (max) coûte 4,52 $ par tâche de l'Artificial Analysis Intelligence Index, soit 2,8x Muse Spark 1.3 (max, 1,60 $), en raison de prix par token plus élevés et d'une utilisation accrue de tokens d'entrée
➤ Tarification des tokens : 4 $ par 1M de tokens d'entrée, 0,20 $ en cache et 20 $ en sortie, contre 1,25 $ / 0,15 $ / 4,25 $ pour Muse Spark 1.3. Cela correspond à Claude Opus 5.5, représente le double de chacun de Claude Sonnet 5.5, Gemini 4 Argon et GPT-6.1 Sol (2 $/10 $), et est 60% en dessous de GPT-6 Astra et Claude Fable 5.1 (10 $/50 $)
➤ Entrée : 7.69M de tokens d'entrée par tâche, soit 28% de plus que Muse Spark 1.3 (max, 6.03M) et 2 à 7 fois Gemini 4 Argon (high), GPT-6.1 Sol (max) et GPT-6 Astra (max). L'entrée représente $3.43 (76%) de son coût par tâche, composé de $1.92 en écritures de cache, $1.44 en hits de cache et $0.07 en entrée non mise en cache
➤ Sortie : environ 54k tokens de sortie par tâche (1,08 $), soit 10% de moins que Muse Spark 1.3 (max, 60k)
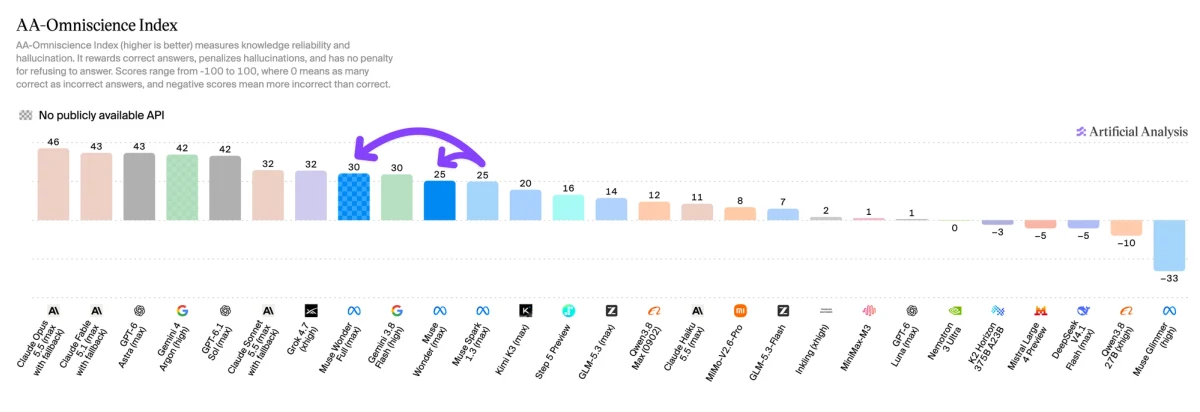
Les connaissances restent un point faible relatif pour les deux modèles, mais cela est atténué par des taux d'hallucination très faibles. Sur AA-Omniscience, Muse Wonder Full (max) obtient 30 et Muse Wonder (max) obtient 25, au même niveau que Muse Spark 1.3 (max), en dessous de Claude Opus 5.5 (46), GPT-6 Astra (43), Gemini 4 Argon (42) et Claude Sonnet 5.5 (32)
Le gain de 5 points de Muse Wonder Full (max) provient de la baisse de son taux d'hallucination (33 % à 23 %), ce qui le place parmi les modèles testés ayant le moins d'hallucinations : il affiche le deuxième taux d'hallucination le plus bas de tous les modèles obtenant 45 ou plus à l'Intelligence Index, derrière seulement Gemini 4 Argon (high, 15 %). Muse Wonder (max) est troisième avec 27 %
Résultats complets de l'Artificial Analysis Intelligence Index pour Muse Wonder Full (max) et Muse Wonder (max) :
Comparez Muse Wonder Full (max) et Muse Wonder (max) avec d'autres modèles de pointe à : https://artificialanalysis.ai/models/muse-wonder-full et https://artificialanalysis.ai/models/muse-wonder