
Si vous exécutez des modèles sur votre Mac ou utilisez MPS comme outil principal d’accélération pour le calcul, il y a beaucoup de choses intéressantes à découvrir dans PyTorch 2.15 ! FP8 est disponible sur MPS, la décodage du modèle linguistique gagne en rapidité à travers les couches linéaires et softmax, et de nouveaux noyaux Metal s’occupent de certaines parties coûteuses de l’audio, du vidéo et des charges de travail d’entraînement.
Un mot rapide sur qui nous sommes : nous sommes l’équipe PyTorch de Hugging Face. Nous contribuons à tout ce qui concerne PyTorch, et l’un de nos domaines d’attention est le backend MPS, dont l’objectif est de faire de votre Mac un lieu de premier ordre pour exécuter et entraîner des modèles PyTorch. Au début de 2026, l’exécution même de petits modèles sur MPS impliquait souvent de travailler avec des opérations non supportées, des problèmes de performance et une croissance inattendue de la mémoire. Ainsi, nous exécutions des modèles réels depuis le Hub Hugging Face pour les langues, les images et les vidéos, identifions où MPS est insuffisante et corrigeons cela en amont dans PyTorch, de plus en plus souvent en remplaçant MPSGraph par des noyaux Metal dédiés. Une grande partie de cet article est le résultat de ce travail, réalisé en collaboration avec les mainteneurs de PyTorch et les contributeurs de la communauté.
TL;DR
- FP8 arrive sur le Mac : stocker les valeurs de
float8_e4m3fndans la moitié de l'espace de BF16, et utiliser la multiplication matricielle étalée ainsi que toutes les autres opérations supportées par CUDA/CPU ! - Les modèles MoE sont 5–6,5 fois plus rapides que dans 2.14 : Qwen3.6-35B-A3B passe de 9,4 à 61,3 tokens/s sur un M3 Ultra, grâce à un matmul groupé natif avec un chemin de décodage dédié, moins de synchronisations GPU-CPU et un routage du top-k plus rapide.
- Moins de temps par token pour chaque LLM : les couches linéaires à une seule ligne utilisent des noyaux matrice-vector spécialisés, et le softmax sur le vocabulaire est environ 8 fois plus rapide.
- Plus de algèbre linéaire sur la GPU : résolution de matrices LU complexes et triangulaires, inversements plus rapides pour les petites matrices, et décomposition QR plus rapide.
- L’audio, le vidéo et l’entraînement reçoivent également de l’attention : des moyens plus rapides pour les convolutions, le padding, le dropout, l’interpolation arrière et les réductions. Le décodage du VAE vidéo de Wan2.2 atteint désormais un pic en mémoire de 8 GiB plutôt que 270 GiB.
- Plus de contrôle via Python : flux MPS publiques et une temporalisation des événements plus fiable.
- Exigences mises à jour : MPS exige maintenant macOS 15 ou ultérieure ; PyTorch 2.15 nécessite Python 3.11 ou ultérieure.
- Un aperçu de 2.16 : concentrez-vous entièrement sur Metal, plus de migrations MPSGraph vers Metal et une décodage des LLM plus rapide.
Qu’est-ce que cela signifie pour vous
Si vous exécutez des modèles sur un Mac avec les transformers, les diffusers ou des outils tels que ComfyUI, voici ce que la version 2.15 change en pratique :
- LLMs locaux beaucoup plus rapides. Les modèles mixtes d’experts décodent 5–6,5 fois plus rapidement que dans 2.14 : sur un M3 Ultra avec
torch.compile, Qwen3.6-35B-A3B passe de 9,4 à 61,3 tokens/s et LFM2.5-8B-A1B de 23,6 à 123,6 tokens/s. Les modèles dense bénéficient également, grâce à des couches linéaires plus rapides et à un softmax 8 fois plus rapide pour le sampling. (Plus) - Génération de vidéo qui s’adapte à la mémoire. La décodage d’une vidéo avec le VAE tiled de Wan2.2 a permis d’augmenter la mémoire du driver à 270 GiB ; elle atteint maintenant un pic d’environ 8 GiB. (Plus)
- Édition correcte de l'image avec Qwen-Image-2.1. Le 2.14, l'encodeur VAE Qwen-Image-2.1 corrompait silencieusement les images sur MPS, endommageant les workflows d'édition d'images (signalé dans ComfyUI). La même modification de padding corrige le problème : une opération encode-décoder correspond désormais à la performance du CPU à 29.95 dB PSNR, contre 10.06 dB auparavant.
- Les poids FP8 sur votre Mac. Les tenseurs FP8 consomment la moitié de la mémoire de BF16, et
F.scaled_mmles multiplie directement sur le GPU. (Plus)
Contenus
- Début de travail
- FP8 arrive sur MPS
- Décodage plus rapide du modèle linguistique
- L’algèbre linéaire reçoit un renforcement
- Convolutions, padding et entraînement
- Softmax et réductions
- Un empreinte de mémoire beaucoup plus faible pour la décodage vidéo
- Plus de contrôle avec les flux MPS
- Plus d’opérations fonctionnent sur MPS
- Un aperçu de PyTorch 2.16
- Résumé
Début de l'utilisation
Vous aurez besoin d’un Mac Apple Silicon avec macOS 15 ou plus récent et Python 3.11 ou plus récent (voir la matrice de compatibilité 2.15). Si votre système d’exploitation est trop ancien ou si aucune GPU Metal n’est disponible, le test de disponibilité MPS vous indique maintenant pourquoi.
Pour tester le candidat de sortie dans un environnement distinct :
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
FP8 arrive sur MPS
FP8 vous offre une autre manière de réduire la mémoire sur votre Mac. PyTorch 2.15 ajoute des tensors torch.float8_e4m3fn sur MPS : un byte par valeur, soit la moitié de l’espace de stockage de FP16 ou BF16.
Vous pouvez multiplier ces tenseurs avec F.scaled_mm, qui permet à la fois la mise en valeur par tenseur et par ligne. Voici un petit exemple avec une seule mise en valeur pour chaque teneur :
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
>Décodage plus rapide du modèle linguistique
Chaque LLM dispose d’une phase de précharge et d’une phase de décodage. Pendant le décodage, chaque nouveau token est traité par le modèle comme une ligne unique, de sorte que les multiplications matricielles importantes se transforment en produits matrice-vector. PyTorch 2.15 accélère les deux types de couches qui dominent cette étape : les couches linéaires dense et les couches mixture-of-experts.
Couches linéaires
MPS dispose de noyaux GEMV pour torch.mm depuis la version 2.14, mais F.linear continue à passer par MPSGraph. PyTorch 2.15 les relie avec F.linear, de sorte que l’entrée de décodage commune [1, 1, hidden_size] les utilise directement, avec les ajouts de bias valides fusionnés en une seule opération. Sur 96 formes de couches BF16 issues de modèles réels, cela représente une 1,23× accélération par moyenne géométrique. Les gains les plus importants se font sur les petites projections, comme les gates dans les modèles MoE, où l’ancien méthode laissait la plupart du bande passante inutilisé. Les couches larges et les têtes LM étaient déjà proches de la limite du bande passante, donc elles restent près de 1×.
Couches Mixture-of-experts
Une couche de mélange d’experts envoie différents nombres de tokens à chaque expert. Le matmul groupé gère ces groupes inégaux en une seule opération, et 2.15 permet à MPS d’obtenir une implémentation native.
Dans 2.14, le matmul groupé copiait les offsets de groupe vers la CPU et parcourrait les groupes. Les noyaux Metal nouveaux lisaient les offsets directement sur la GPU, en utilisant les Performance Primitives Metal lorsque disponibles et une voie Metal distincte ailleurs. Les petits groupes, cas courant pendant le décodage, reçoivent également leur propre noyau.
Par exemple, 64 mots peuvent être divisés en groupes de 16, 32 et 16 :
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
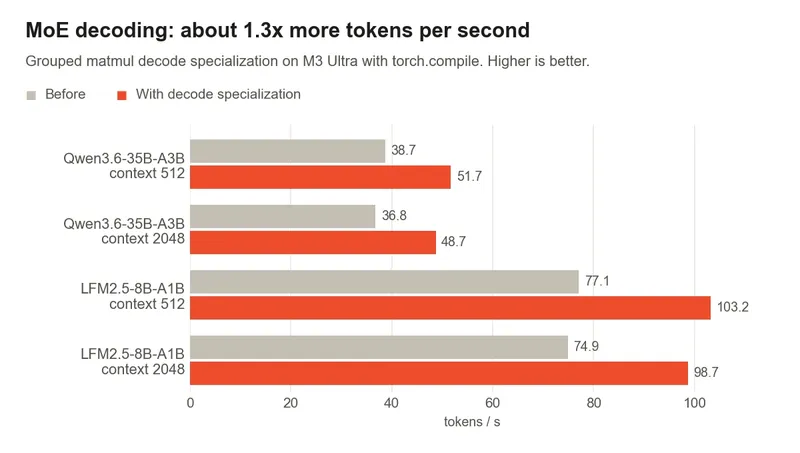
Le noyau de décodage apparaît directement dans le débit de tokens. Sur un M3 Ultra avec torch.compile, les modèles MoE génèrent environ 1,3 fois plus de tokens par seconde :

L’algèbre linéaire reçoit un renforcement
Calculs à valeurs complexes
Travailler avec des tenseurs complexes devient plus facile. complex64 facteurisation LU, résolution LU et résolution triangulaire fonctionnent maintenant sur MPS, ce qui permet également d’utiliser les opérations et les gradients basés sur eux, comme les déterminants complexes. Voici un petit système résolu directement sur le GPU :
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
Petites matrices et solutions plus grandes
Les matrices de petite taille possèdent également des noyaux rapides. Pour la géométrie de la caméra et les transformations d’image, des lots de matrices FP32 allant jusqu’à 4 × 4 sont inversées en un seul noyau Metal qui combine factorisation et résolution. Les problèmes plus importants reçoivent également de l’attention : la QR utilise des mises à jour bloquées, et les solutions triangulaires transforment une grande partie de leur travail en multiplication efficace de matrices.
Les charges de travail Gated DeltaNet bénéficient d’un chemin rapide dédié pour des lots de systèmes triangulaires FP32 de 16 × 16, 32 × 32 et 64 × 64, comprenant au moins huit côtés droits.
SVD est également plus robuste aux extrêmes numériques. Il gère désormais correctement les très petits valeurs singulières, les très grandes ou très petites magnitudes d’entrée et la complétion de la base avec full_matrices=True, ce qui rend les résultats de pseudo-inverse et de moindres carrés plus fiables.
Convolutions, padding et entraînement
Les modèles audio, les décodeurs vidéo et les boucles d’entraînement impliquent des opérations coûteuses. Cette version introduit plusieurs de ces fonctionnalités avec de nouvelles voies via Metal :
| Opération | Quels changements dans 2.15 |
|---|---|
conv1d forward |
Les noyaux spécialisés remplacent MPSGraph, ainsi qu’un chemin im2col-plus-matmul pour des sorties courtes. Utile pour les formes de modèles audio et de streaming. |
| Définition de padding constante | Mouvements vers les noyaux Metal, correction de l’augmentation incontrôlée du driver et de la mémoire dans la décodage VAE vidéo tiled (plus en détail ci-dessous). |
| Reflexion et remplissage de la réplication | Nouvelles implémentations de métal plus rapides et qui corrigent la cohérence arrière. |
| Dropout hors de place | nn.Dropout et F.dropout utilisent désormais le noyau fusionné existant. |
| Upsampling backward | Un noyau de regroupement métallique remplace le chemin de réglage de gradient MPSGraph. |
En dernier dans les canaux conv2d vers l’arrière |
Il reste sur un chemin efficace basé sur les canaux, plutôt que sur un graphique NCHW avec un accès parallèle coûteux. |
Softmax et réductions
Le prélèvement des tokens devient plus rapide dans 2.15 également. softmax et log_softmax Maintenant fonctionné sur des noyaux Metal dédiés, et les grands vocabulaires bénéficient le plus : une FP32 softmax sur un [1, 128256] une rangée de logits tombe 57 µs à 7 µs, à propos 8 fois plus rapide par rapport à la version MPSGraph. L’accélération se maintient pour tous les autres tailles de vocabulaire courants :

Un empreinte de mémoire beaucoup plus faible pour la décodage vidéo
L’un des résultats les plus remarquables de cette version provient du changement de remplissage constant. La décodage VAE dans Wan-AI/Wan2.2-TI2V-5B-Diffusers effectue 8 764 appels de remplissage lors d’une décodage complète à 28 tiles. Avec le remplissage sur Metal, la mémoire du driver de pointe diminue de environ 270 GiB à 8 GiB :

| Métrique de mémoire | MPSGraph padding | Remplissage en métal |
|---|---|---|
| Pic de l'allocation de tenseur actuelle | 4.422 GiB | 4.095 GiB |
| Allocateur-réservé point culminant | 8.070 GiB | 8.070 GiB |
| Pente maximale totale conducteur-mémoire | 270.135 GiB | 8.108 GiB |
Plus de contrôle avec les flux MPS
Vous pouvez maintenant choisir le flux MPS qui exécute votre travail, directement depuis Python. torch.mps.Stream et le torch.mps.stream context manager fournissent cette interface, et Tensor.record_stream permet à l’allocateur de suivre l’utilisation d’un tensor sur un autre flux.
Voici un petit exemple qui envoie le travail vers une flux distinct et le synchronise avant de lire le résultat :
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
Plus d'opérations fonctionnent sur MPS
Plusieurs autres opérations sont désormais exécutées sur MPS : torch.frexp, torch.logspace, torch.take et Tensor.put_, torch.heaviside, torch.special.laguerre_polynomial_l et comparaisons de nombres entiers non négatifs. logspace ne prend pas encore en charge les sorties entières ou booléennes comprenant plus d’un élément.
L’attention reçoit également une correction de précision : la mise en œuvre mathématique de MPS pour l’attention du produit scalaire se fait maintenant gère correctement les diffusions par lot et les diffusions principales.
Un aperçu de PyTorch 2.16
Le travail sur la version 2.16 est déjà bien en cours. Certaines des modifications suivantes ont été appliquées à main et sont disponibles dans les builds nocturnes ; d’autres sont encore en revue, donc les détails peuvent changer avant la sortie.
Décodage plus rapide des LLM
Une fois que le chemin de décodage d’un modèle ne contient plus aucune opération MPSGraph, la GPU ne commence à travailler qu’après que la CPU a terminé l’encodage de tous ses noyaux. PyTorch 2.16 envoie le buffer de commandes tous les 16 noyaux, de sorte que la GPU peut commencer à travailler tandis que la CPU continue d’encoder le reste. Pour le décodage compilé en BF16 dans un contexte de 2048 tokens :
| Modèle | Avant | Après | Changer |
|---|---|---|---|
| LFM2.5-8B-A1B | 108,8 tokens/s | 126,0 tokens/s | +16% |
| Qwen3.6-35B-A3B | 52,9 tokens/s | 62,8 tokens/s | +19% |
| Qwen3.8-27B | 12.1 tokens/s | 12.6 tokens/s | +4% |
L’attention fonctionne entièrement sur Metal
L’attention à produit de points élevée est enlevant complètement MPSGraph : toutes les formes seront exécutées avec des noyaux Metal, avec des noyaux vectoriels dédiés pour la décodage et des Primitifs de performance Metal pour le préchargement à demi-precise sur les nouvelles versions de macOS. Les formes qui devaient recourir à MPSGraph bénéficient le plus. Sur un M5 Pro, la décodation avec l’attention par requêtes groupées (32 têtes de requête, 8 têtes KV, dimension de la tête 80, contexte 4K) passe de 465 µs à 65 µs, et un préchargement 4K × 4K avec une dimension de la tête 40 passe de 42 ms à 6 ms.
Plus de migrations MPSGraph vers Metal
Le passage de MPSGraph se poursuit. Les normes par lot avant‑dernière et après‑dernière sont en cours, tandis que la perte MSE (jusqu’à 12 fois plus rapide pour les entrées petites), std_mean et var_mean (jusqu’à 4 fois plus rapide) et bincount ont déjà été intégrés. bincount est le plus spectaculaire : lorsque la plupart des valeurs se situent dans un même bin, le comptage de 4 millions d’entiers prenait 6,8 secondes, et maintenant il ne prend que demi millisecond.
Une installation plus petite
Les shaders packés seront construit par défaut pour Metal 3.1, tandis que les versions pour Metal 4 sont compilées uniquement pour les noyaux qui en ont besoin. Cela réduit libtorch_cpu.dylib d’environ 25 %, passant de 384 MiB à 287 MiB, et pose les bases pour les shaders Metal 4.1 avec une multiplication matrice plus rapide et des matrices en FP8 natives.
Résumé
PyTorch 2.15 introduit le FP8 sur Mac, une décodage plus rapide des LLM pour les modèles dense et MoE, davantage d’algèbre linéaire sur le GPU, ainsi qu’une longue liste d’opérations transférées de MPSGraph vers des noyaux Metal dédiés. Essayez le candidat de sortie !
Qu’est-ce qui va se passer pour nous
- Plus de MPS : 2.16 se concentrera entièrement sur Metal, et nous continuerons à déplacer les opérations depuis MPSGraph.
torch.compile: Nous nous efforçons d’éliminer les interruptions du graphe, afin que davantage de modèles puissent être compilés en entier.- Vos idées : Sur quoi d’autre devrions-nous travailler avec PyTorch ? Si quelque chose est lent, manquant ou défectueux, sur MPS ou ailleurs, ouvrez un issue sur GitHub et communiquez avec nous.
Un grand merci à Nikita Shulga, Kurt Mohler et Aaron Gokaslan pour avoir revu une grande partie de ce travail, ainsi qu’à tous ceux qui ont contribué à MPS dans cette version.